
Ở bài trước, mình chạy Pi harness của mình với deepseek/deepseek-v4-flash-0731 trên 50 task SWE-bench Verified Mini và được 35/50 — 70%. Cuối bài mình hứa bài sau sẽ làm thí nghiệm “stock Pi so với Pi cộng custom harness”. Trước khi làm thí nghiệm đó, mình đọc lại transcript, sửa cả harness lẫn benchmark runner (pi-bench), rồi chạy lại hai lần nữa với cùng model và cùng 50 task. Mình có đưa ra một số vấn đề cần cải thiện trong harness và trong runner, và có một vài kết luận khá thú vị :)
Xem những phần trước:
- Phần 1: Pi coding agent của mình đạt 35/50 SWE-bench Verified Mini — nhưng 15 task fail mới là phần thú vị
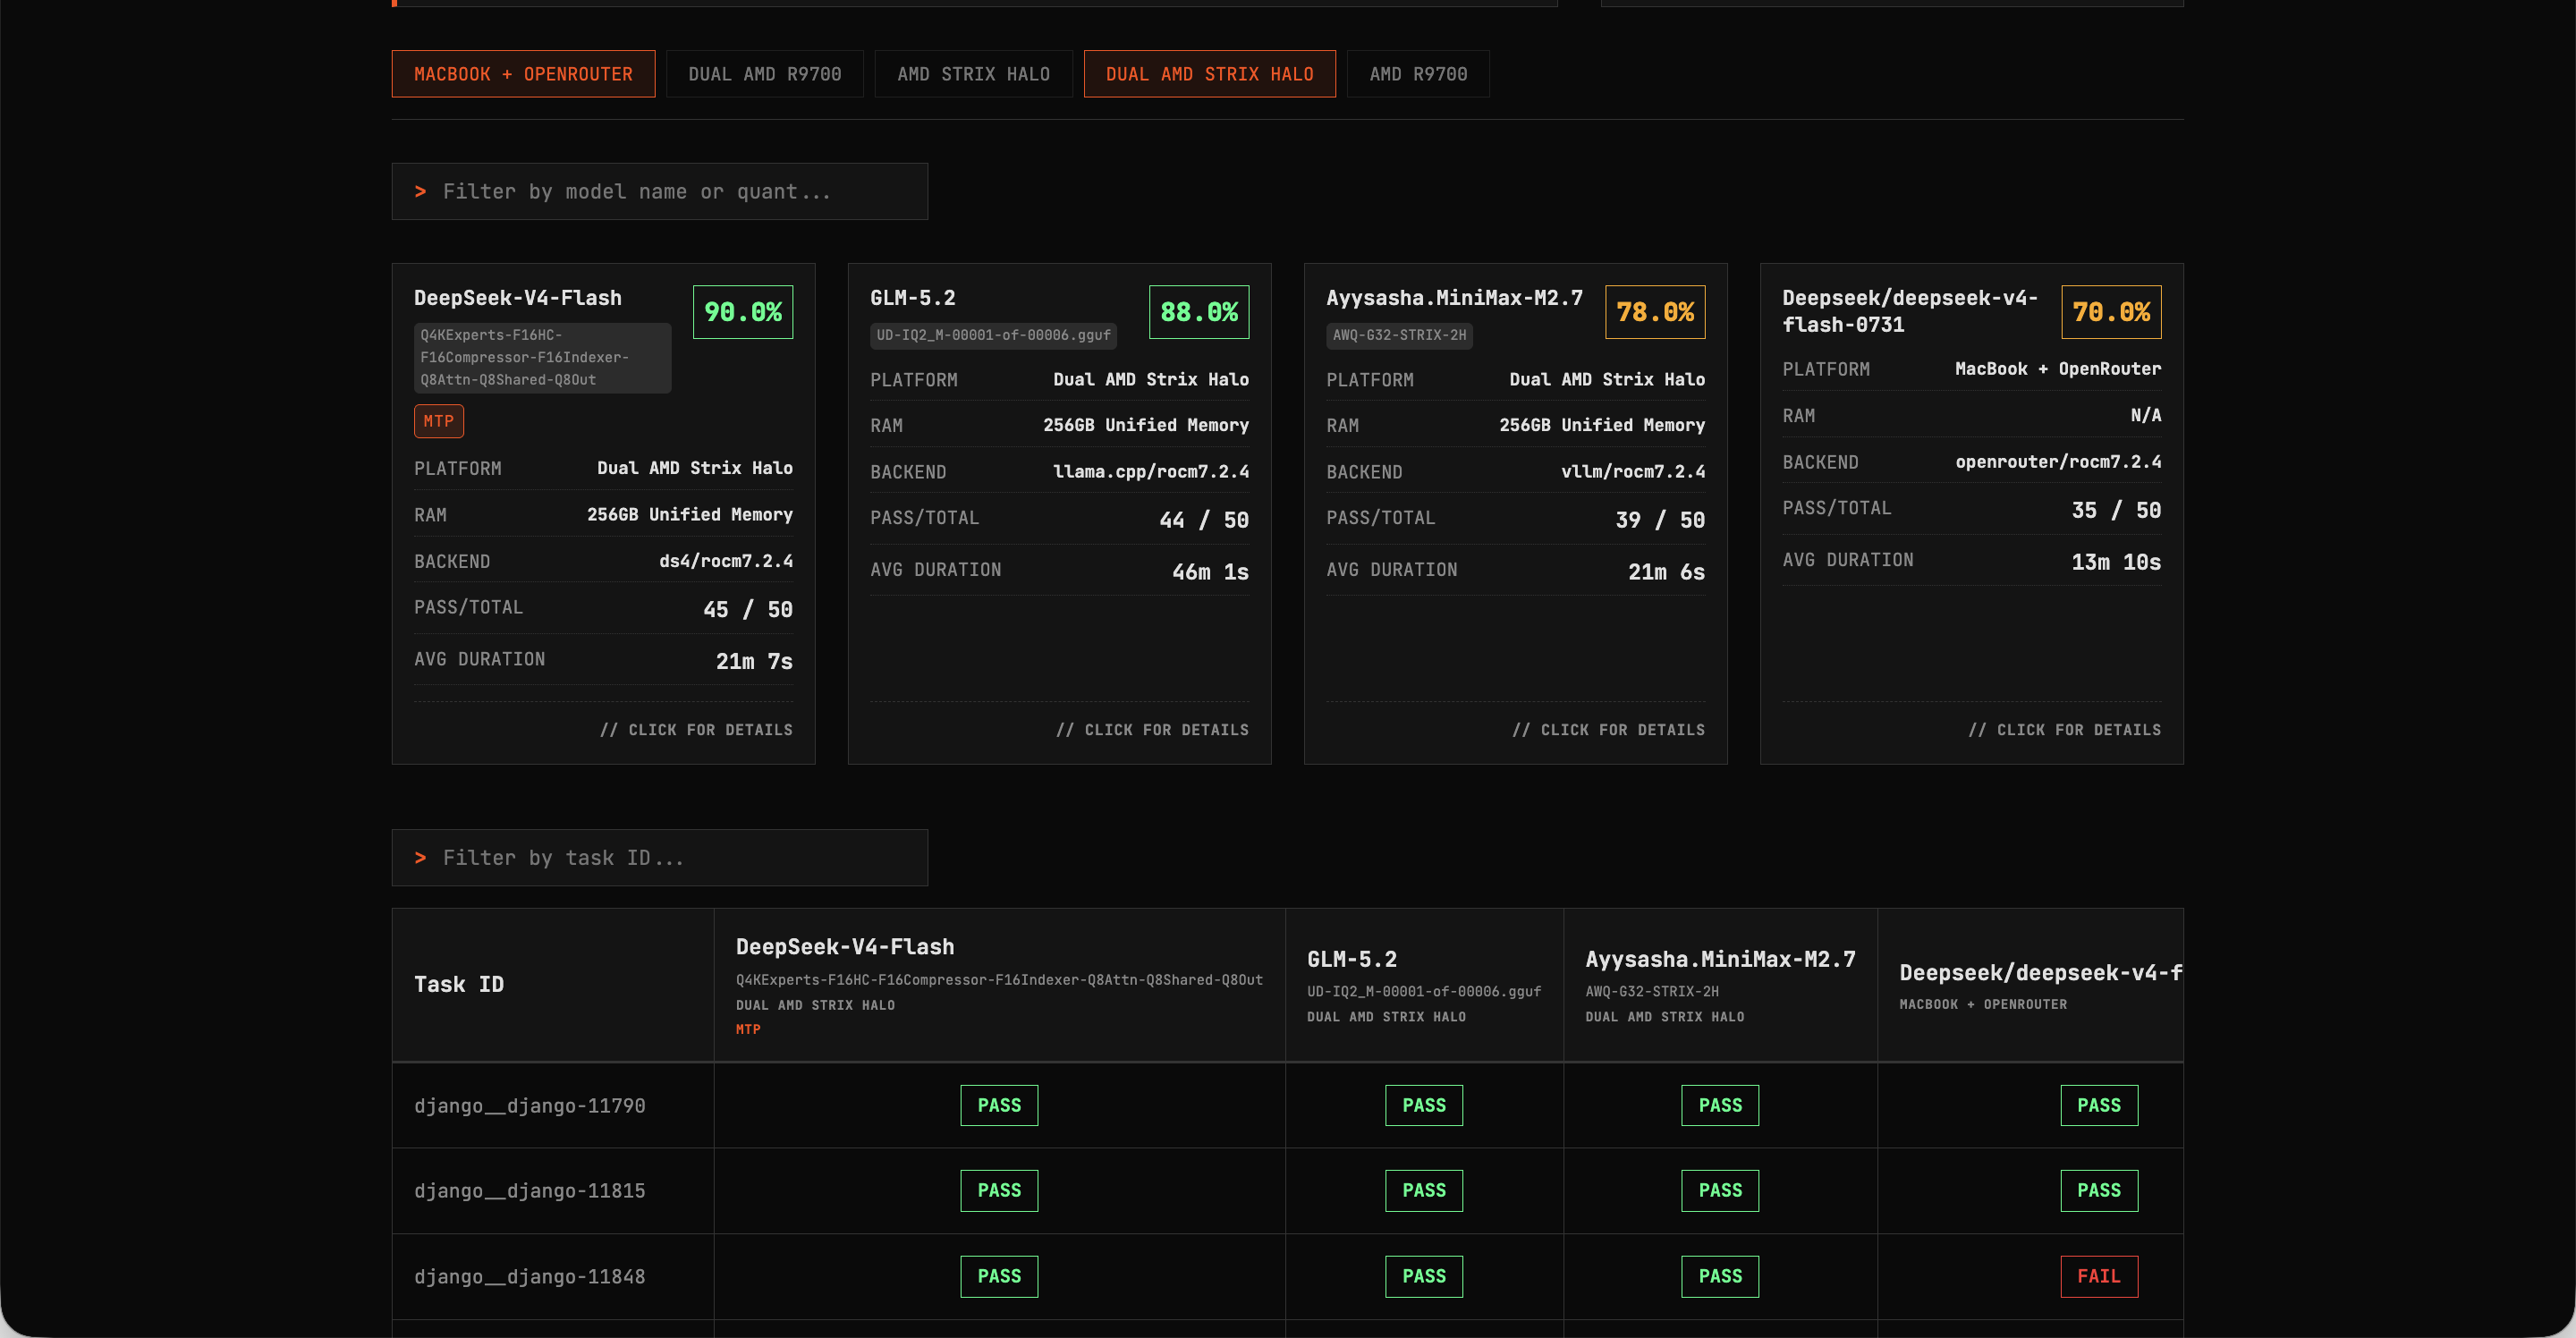
Tổng quan kết quả
| Run | Ngày chạy | Pass rate | Note |
|---|---|---|---|
| v1 | 29–30/08 | 35/50 = 70.0% | Harness gốc |
| v2 | 14/09 | 44/50 = 88.0% | Harness mới + verification retry |
| v2.1 | 16–17/09 | 45/50 = 90.0% (*) | Làm cứng benchmark runner |
(*) Tính cả 2 task có dữ liệu hỏng từ dataset như fail. Nếu loại chúng khỏi mẫu số thì là 45/48 = 93.8%.
Toàn bộ phân tích chi tiết nằm ở debug/analysis_report_deepseek-v4-flash-v1-v2-v2.1.md trong repo pi-bench, kèm script scripts/analyze-runs.py để tái tạo các con số trong bài này. Lưu ý summary.json của v2 và v2.1 liệt kê mỗi task hai lần (totalTasks: 100) và durationMs không tính giai đoạn retry, nên script khử trùng theo task id và lấy thời gian từ timestamp trong transcript.
Nhìn qua thì đây là một sự tiến triển rất tốt, score tăng lên rất đẹp. Nhưng khi đọc lại transcript của cả 150 lần chạy, mình thấy con số này kể một câu chuyện khác:
TL;DR — Sau hai lần điều chỉnh, kết quả tăng từ 35/50 lên 45/50. Nhưng mức tăng này không thể đọc đơn giản là “harness tốt hơn”: nếu bỏ verification retry thì v2 chỉ đạt 37/50, tức phần lớn bước nhảy đến từ việc agent được nhìn output test thật; bước từ v2 lên v2.1 chủ yếu là mẫu số (2 task dữ liệu hỏng) và nhiễu. Ngoài ra container vẫn có internet nên agent có thể
pip downloadcode upstream, làm các con số tuyệt đối bị thổi phồng một lượng chưa biết (gần như đều ở cả ba run, nên không giải thích khác biệt giữa các run). Điều đáng chú ý nhất vì thế không phải con số 90%, mà là quá trình tách xem phần cải thiện nào đến từ agent và phần nào do cách benchmark được thiết kế.
Những thay đổi chính
Trước khi sửa gì, mình đọc lại tất cả transcript của v1 và thấy vài vấn đề của harness:
- Agent chưa hiểu được lý do fail ở lần đầu tiên và không thể có hướng để giải quyết. Dẫn tới việc không giải được các edge case hay viết code tạo ra regression test fail.
- Agent không sử dụng hết các tool, skill mình đưa cho.
Ngoài harness của Pi, mình cũng chỉnh lại pi-bench (benchmark runner) ở một số điểm:
- Model gọi các tool
question,questionnaire— thực ra cần con người trả lời — nên mình loại chúng khỏi tool list. - Sửa lỗi ở bước đưa bộ test vào container: kiểm tra
FAIL_TO_PASSkhi import và gọi test bằngexecFilethay vì shell. - Đưa thêm tín hiệu về môi trường: giới hạn 30 phút cho mỗi task, nudge khi agent đào git history, nudge khi đã dùng nửa thời gian.
Mình sẽ mô tả kỹ hơn ở hai phần dưới: v1 → v2 (chủ yếu là harness, kèm phản hồi từ runner) và v2 → v2.1 (làm cứng runner).
Mình đã đổi gì từ v1 sang v2
Thứ đầu tiên mình muốn đổi là Harness của Pi agent, thứ đầu tiên mình tập trung đổi là AGENTS.md hay mình gọi là Operating Manual của agent để mô tả lại workflow làm việc mình mong muốn. Nói nôm na là bước này mình chỉ Prompt Engineering cho system prompt nó hợp lý hơn.
Mình lấy idea từ 3 hướng chính:
- andrej-karpathy-skills (repo của multica-ai): một mô tả về những lỗi hay gặp của coding agent trong một file CLAUDE.md duy nhất thay đổi behavior của nó.
- Secret sauce từ cộng đồng mình mò được và áp dụng thử vào nó. Bạn có thể đọc thử một vài bài như Claude Code’s Real Secret Sauce (Probably) Isn’t the Model
- Effective context engineering for AI agents
Ngoài ra một số chỉnh sửa nhỏ khác về code trong extensions cho tool như note, plan, …
Mục tiêu của mình để agent có thể follow theo một workflow hoàn chỉnh:
- Plan: hình thành nên kế hoạch trước khi làm việc gì đấy.
- Test: RED code trước, reproduce được issue / bug trước theo yêu cầu.
- Implement: thực thi những chỉnh sửa với từng bước nhỏ nhất, làm cho RED biến thành GREEN.
- Review: Xem xét lại mọi thứ trước khi báo là mình đã xong, đọc lại những chỉnh sửa và đánh giá.
- Verify: trực tiếp chạy những lệnh kiểm tra (linting, code style, …) trước khi chạy final test suite
- Remember: Log những thứ mình đã làm, ghi nhớ lại các công việc đã làm.
- Improve: Cải thiện nó từ những kết quả trong vòng lặp trước đó và chỉnh sửa bản thân.
Theo quan sát của mình khi đọc transcript, cách Pi làm việc có thay đổi. Đây là quan sát định tính, chưa chắc đã chuyển thành pass rate: số task pass ngay lần đầu chỉ tăng từ 35 lên 37 trên 50 task, nằm trong vùng nhiễu.
- Nó đọc code kỹ hơn trước khi sửa.
grep— tool mà v1 chưa gọi lần nào — xuất hiện khoảng 100 lần ở v2, vàreadtăng từ 350 lên khoảng 425 lần. Idea của mình là agent sẽ cần “probe the machine” - giống như một ông thợ sửa điện sẽ phải vặn lên vặn xuống để hiểu rõ vấn đề. - Nó chạy test nhiều hơn:
run_testđược dùng ở khoảng 23 task ở v2 so với 15 task ở v1. Review và verify kỹ, tạo regression test là cảm nhận của mình khi đọc transcript (mình chưa đếm). - Todo list được dùng ở nhiều task hơn ở v2.1 (khoảng 26 so với 20 ở v1). Tool
notethì đã được dùng ở 47/50 task ngay từ v1, nên đây không phải thứ AGENTS.md mới thêm.
(Số liệu của v2 và v2.1 ở trên đã chia đôi, vì thư mục kết quả chứa các file transcript trùng lặp.)
Vì v2 đổi cả AGENTS.md lẫn runner (retry, nudge, timeout) cùng lúc, mình không tách được đóng góp riêng của AGENTS.md. Bằng chứng trực tiếp duy nhất là verification retry cứu được 7 task (xem phần 1).
Nhưng một vấn đề cực lớn là AGENT KHÔNG SỬ DỤNG ĐƯỢC SKILL VÀ CÁC TOOL KHÁC NHƯ SUBAGENT :) Cái này gọi là “failed successfully” thì có đúng không nhỉ ? :) Trong cả 150 transcript không có lời gọi skill hay subagent nào (chỉ có task_run và task_stop ở một task của v2).
Nó vẫn chỉ tập trung sử dụng các built-in tool là: bash, grep, read, …; những tool mình đưa thêm cho plan, note, test; và một vài tool để hạn chế tràn context.
Mọi người có thể coi latest AGENTS.md file tại đây.
Mình đã đổi gì từ v2 sang v2.1
Ở v2 mình chạy harness mới cùng với những thay đổi runner đầu tiên: verification retry, nudge khi agent đào git history, giới hạn 30 phút cho mỗi task. Kết quả tăng rõ. Khi đọc transcript, mình thấy agent thực sự vượt qua được lần fail đầu tiên nhờ tín hiệu từ test thật; mình coi đây là một điều tốt.
Nhưng vẫn còn vấn đề: 5/50 task bị timeout (6 task chạy tới ít nhất 28 phút), và 14 task bị nudge vì đào git history (tổng 22 lần), tức là agent đang tìm lời giải ngoài code thay vì tự giải. Mình sẽ nói rõ hơn ở dưới.
v2.1 vì vậy tập trung làm cứng runner: kiểm tra FAIL_TO_PASS khi import (loại task dữ liệu hỏng), gọi test bằng execFile, chặn sửa file config, cắt hết git history (chỉ còn một commit baseline), và nudge khi đã dùng 50% thời gian. Lưu ý quy tắc “Do NOT use git clone or download any repositories” đã có sẵn trong prompt từ v1, nên nó không phải thay đổi mới của v2.1.
Tổng kết: Giữa ba lần chạy, mình đã đổi gì?
Model, danh sách task và cách chấm bằng container test giữ nguyên. Phần thay đổi là harness và benchmark runner (pi-bench):
| Thay đổi chính | |
|---|---|
| v1 | Harness gốc. Chưa có retry, chưa có nudge (gợi ý, khuyến khích, …). |
| v2 | Thay đổi Harness cho Pi, mô tả các bước trong workflow cụ thể; chỉnh sửa các extension chính. Benchmark runner: thêm verification retry: nếu test thật fail, agent được một lượt sửa nữa và được đưa output FAIL_TO_PASS thật. Thêm nudge khi agent sa đà vào git archaeology, judge chắc chắn hơn, sửa môi trường container (Node 22, ripgrep), và thêm timeout 30 phút. |
| v2.1 | Sửa Benchmark Runner. Kiểm tra dữ liệu FAIL_TO_PASS khi import và loại task hỏng khỏi mẫu số (harness-error), gọi test bằng execFile thay vì shell, chặn sửa file config, cắt hết git history (chỉ còn một commit baseline), và nudge khi đã dùng 50% time budget. |
Mỗi run chỉ chạy một lần (pass@1). Mình sẽ quay lại hệ quả của điều này ở phần “Nên đọc những con số này thế nào?”.
Kết quả nhìn từ ngoài
| Metric | v1 | v2 | v2.1 |
|---|---|---|---|
| Pass rate (50 task) | 35/50 = 70.0% | 44/50 = 88.0% | 45/50 = 90.0% |
| Cùng 48 task (bỏ 2 task dữ liệu hỏng) | 72.9% | 91.7% | 93.8% |
| Tổng thời gian chạy agent | 652 phút | 533 phút | 425 phút |
| Số task chạy quá 20 phút | 8 | 6 | 1 |
| Chi phí agent | $2.35 | $2.20 | $1.99 |
| Chi phí trên mỗi task giải được | $0.067 | $0.050 | $0.044 |
Từ v1 sang v2 có 11 task chuyển từ fail sang pass và 2 task chuyển ngược lại (kiểm định McNemar exact p = 0.022). Đây là bước nhảy thực sự, không phải nhiễu. Câu hỏi là nó đến từ đâu.
1. Phần lớn bước nhảy từ v1 lên v2 là do mình đo thứ khác
Bài học thứ nhất — Agent không cần bị “thúc” thêm một lần, nó cần được nhìn thấy test fail như thế nào. Retry hiệu quả vì agent nhận được output thật của test, tức là phản hồi cụ thể.
Mình đã có lưu lại một tham số là số lần retry khi verify Verification retry, chỉ chạy khi lần test thật đầu tiên fail. Vì vậy nếu một task có verificationRetries = 1 và cuối cùng pass, đó là bằng chứng trực tiếp rằng retry đã cứu task đó.
| v1 | v2 | v2.1 | |
|---|---|---|---|
| Task cần dùng retry | không có | 9 | 7 |
| Task được retry cứu | không có | 7 | 4 |
| Pass ngay lần đầu (không cần retry), trên 50 task | 35 (70%) | 37 (74%) | 41 (82%) |
Nếu bỏ retry đi, v2 chỉ đạt 37/50 = 74%, hơn v1 đúng 4 điểm phần trăm. Khoảng 14 điểm còn lại là vòng phản hồi, không phải lần thử đầu tiên tốt hơn.
Điều này không có nghĩa retry là xấu. Nó là một tính năng harness hợp lý, và trong thực tế agent luôn có thể chạy test. Nhưng nó thay đổi ý nghĩa của con số: v2 và v2.1 đo “agent cộng với một vòng phản hồi từ test chấp nhận”, không còn là pass@1 thuần như v1. Nếu mình đặt 88% cạnh 70% mà không nói rõ điều đó thì đang so hai thứ khác nhau.
Tuy nhiên đây là một điều mình mong muốn, agent cần nhận được tín hiệu nhiều hơn, test đúng, test sai, thậm chí là tín hiệu từ hệ thống và con người.
2. Từ v2 lên v2.1: chủ yếu là mẫu số và nhiễu
Số task pass chỉ đi từ 44 lên 45 (88.0% → 90.0%). Phần còn lại của bước nhảy sang 93.8% đến từ việc hai task có dữ liệu hỏng bị loại khỏi mẫu số:
django__django-12209: trườngFAIL_TO_PASSchứa một docstring thay vì tên test, nên runner chạy cả test suite của Django rồi hết timeout.sphinx-doc__sphinx-8265: node id của pytest bị cắt cụt (test_unparse[(1,), nên test không bao giờ chạy.
Hai task này không thể thắng, ở cả v1 lẫn v2, nhưng lại bị tính là fail. Loại chúng ra là đúng. Nhưng nó có nghĩa là 70% ở v1 thực ra là 35/48 = 72.9% nếu so cùng mẫu.
Còn chuyện các task còn lại thì sao? Giữa v2 và v2.1 có 10 trên 50 task đổi trạng thái pass lần đầu (mất 3, được 7), trong khi tổng ròng chỉ tăng 4. Model giống nhau, prompt gần như giống nhau. Vậy độ nhiễu của một lần chạy đơn lẻ vào cỡ vài task. Chênh lệch 44 so với 45 không nói lên điều gì.
Vậy v2.1 tốt hơn ở điểm nào? Ở tốc độ và độ bền:
- Tổng thời gian giảm 20% so với v2 và 35% so với v1. Có thể một phần nhờ signal “còn 50% thời gian” (9 task nhận được nudge này) làm agent chuyển sang edit sớm hơn thay vì thử - sai lòng vòng, nhưng mình chưa tách được.
- Số task chạy quá 20 phút giảm 8 → 6 → 1.
- Không còn nudge git archaeology nào (22 lần ở v2), không còn diff rỗng. Vì git history đã bị cắt, agent không còn đường cheat qua git — nhưng như phần sau cho thấy, nó vẫn còn đường qua network.
sphinx-9320, task mất 45 phút và không sửa một dòng source nào ở v1, chỉ còn 4 phút.
Nguyên nhân khả dĩ nhất là git scrub (cắt hẳn git history ở trên baseline) và time-budget nudge. Với một lần chạy đơn, mình không tách được phần đóng góp của từng thứ.
3. Scrub git history xong, container vẫn còn internet
Đây là phát hiện mình không ngờ tới. Ở bài trước mình viết “tắt web_search và web_fetch” trong bảng benchmark contract, và đề xuất chặn git log để agent không thấy commit tương lai. Ở v2.1 mình đã làm phần thứ hai: mỗi container chỉ còn một commit benchmark-baseline, mọi tag và ref khác đều bị xoá.
Nhưng khi đọc lại lệnh bash của agent, mình thấy nó làm thế này:
pip download django==3.2.25 --no-deps -d /tmp/djdl
Container có internet, pip chạy bình thường. Agent tải một bản Django mới hơn bản đang sửa. Bản đó đã chứa sẵn fix.
Một ví dụ cụ thể, task django__django-11815 ở v2. Agent tải wheel Django-3.2.25, giải nén serializer.py, in ra class EnumSerializer:
'%s.%s[%r]' % (module, enum_class.__qualname__, self.value.name)
Diff cuối cùng agent nộp gần như y hệt (chỉ khác __name__ thay cho __qualname__):
'%s.%s[%r]' % (module, enum_class.__name__, self.value.name)
Tương tự, ở v2.1 task sphinx-10435 đọc trực tiếp latex.py, test và CHANGES của Sphinx v5.0.1 qua raw.githubusercontent.com.
Số liệu mình đếm được (chỉ tính những lần tool result chứng minh việc tải thành công, nên đây là cận dưới):
| v1 | v2 | v2.1 | |
|---|---|---|---|
| Task có tải thành công code upstream | ≥ 10 / 50 | ≥ 10 / 50 | ≥ 9 / 50 |
Số lệnh pip download |
18 | 25 | 35 |
Vài điểm cần nói rõ, để không kết luận quá tay:
- Việc này xảy ra ở cả ba run, kể cả v1, và tỷ lệ gần như không đổi. Vì vậy nó không giải thích khác biệt giữa các run. Nó làm cho mọi con số tuyệt đối đều bị thổi phồng một lượng chưa biết.
- Agent có thể tải khi task khó, nên pass rate của nhóm task “có tải” không nói lên quan hệ nhân quả. Mình cũng chưa kiểm từng trường hợp để biết agent tận dụng code tải về đến đâu.
web_searchvàweb_fetchđã tắt thật, nhưngbashcộng vớipip,curl,urllibđi vòng qua hoàn toàn.
Bài học thứ hai: khi chặn một đường rò rỉ, hãy tự hỏi agent còn đường nào khác để đi tới cùng đích. Scrub git history giải quyết đúng một trong hai đường. Cách xử lý đúng là chặn network egress của container, chỉ cho phép host của LLM API, rồi chạy lại những task đã tải code upstream để đo mức độ thổi phồng.
4. Ba lỗi khác của chính runner
Khi kiểm từng task fail còn lại, mình tìm thêm ba thứ nữa nằm ở runner hoặc dữ liệu, không phải ở model.
Agent bị “nudge” tới chết
Nudge git archaeology hoạt động bằng cách gọi session.abort() rồi gửi lại một prompt cảnh báo. Khi hết ngân sách nudge (2 lần), code in ra “letting normal flow continue” rồi break khỏi vòng lặp. Nhưng session vừa bị abort, nên không còn gì tiếp tục: run kết thúc với bất cứ diff nào đang có.
Ở v2, sphinx-10323 và sphinx-9229 bị đúng kiểu này: nhận đủ hai cảnh báo, quay lại git show lần thứ ba rồi bị abort, kết thúc với diff rỗng. sphinx-10323 pass ở v1 và v2.1, nên đây là điểm mất oan. v2.1 không dính chỉ vì scrub đã loại nguyên nhân kích hoạt. Lỗi vẫn còn nguyên trong code.
Test fixture của agent xung đột với test patch chính thức
Task sphinx-11510 fail ở cả v2 và v2.1 dù judge đọc diff và kết luận code fix “khớp chính xác với lời giải chuẩn”. Nguyên nhân là chuỗi lệnh này:
- Runner chạy
git add .để lấy diff, việc này stage luôn các file test mới mà agent tạo. - Runner
git checkout HEAD -- tests/vàgit clean -fd tests/để trả test về trạng thái sạch. Cả hai lệnh đều không xoá được file đã nằm trong index nhưng chưa có trong HEAD. git applytest patch chính thức thất bại vì file đã tồn tại, runner rơi xuốnggit apply --3way, và kết quả là xung đột add/add: file fixture chứa<<<<<<< ours.- pytest chết với
SyntaxErrorngay khi setup fixture.
Mình tái hiện đúng chuỗi này trong một repo git nhỏ, và xác nhận rằng chỉ cần git reset -q HEAD -- tests/ trước git checkout là test patch áp dụng sạch.
Một task có khả năng cao là dữ liệu hỏng
sphinx-9229 fail y hệt ở cả ba run, với lỗi No module named 'target'. Judge ở v2.1 đọc diff và thấy nó “gần như giống hệt” lời giải chuẩn. Test patch trong dataset thêm hàm test_class_alias_having_doccomment(app) mà không có marker @pytest.mark.sphinx(..., testroot='ext-autodoc'), nên test chạy với testroot mặc định. Đây rất có thể là entry hỏng thứ ba, nhưng mình chưa đối chiếu với SWE-bench gốc nên chưa kết luận chắc.
5. LLM judge lần này lại có ích
Ở bài trước mình rút ra “test quyết định score, judge chỉ giải thích”. Điều đó vẫn đúng. Nhưng lần này mình thấy một công dụng mới cho judge.
Ở v2.1, trong 48 task được chấm, chỉ có đúng hai task mà judge và container test bất đồng: sphinx-11510 và sphinx-9229, cả hai đều judge = đúng, test = sai. Đó chính là hai task mình nghi có lỗi ở runner hoặc dữ liệu.
Vậy quy tắc “judge nói đúng nhưng test nói sai” là một cảnh báo rẻ để phân loại nhanh failure sau mỗi lần chạy: nó chỉ ra đúng chỗ cần đọc transcript. Mình không dùng judge để đổi điểm. Mình dùng nó như một bộ dò lỗi cho benchmark.
Nên đọc những con số này thế nào?
Nếu phải tóm gọn thành vài câu mình sẽ dám nói:
- Với retry và các sửa lỗi runner, cấu hình hiện tại giải được khoảng 44–45 trên 48 task hợp lệ ở lần chạy đơn, đã bao gồm việc agent có thể tải code upstream.
- Pass ngay lần đầu là khoảng 74–82% (trên 50 task), và khoảng cách giữa hai con số này nằm trong vùng nhiễu.
- Chênh lệch 1–3 task giữa hai lần chạy không thể coi là cải thiện.
- Khoảng 10 task trong 50 là loại “lúc pass lúc fail” khi chạy lại, nên mình cần nhiều lần chạy hơn, không chỉ một.
Nếu sphinx-11510 được sửa thì v2.1 có thể lên 46/48, và nếu sphinx-9229 đúng là dữ liệu hỏng thì 47/48. Đó là cận trên cần xác nhận bằng cách chạy lại sau khi sửa, không phải kết quả đã có.
Kết luận
Ở bài trước mình nói harness cũng là software. Sau hai lần chạy lại, mình muốn thêm một vế: benchmark cũng là software, và nó rò rỉ theo đúng những cách mà software hay rò rỉ.
Thứ mình học được không phải “model đạt 90.0%”. Mà là:
- Agent cần phản hồi cụ thể (retry với output test thật) và những tín hiệu để điều hướng nó làm gì.
- Chặn một đường rò rỉ không có nghĩa là đã chặn hết. Agent luôn tìm được đường còn lại.
- Một lần chạy đơn chỉ đủ để thấy chênh lệch lớn; chênh 1–3 task là nhiễu.
Việc tiếp theo
Mình sắp xếp lại thứ tự so với những gì hứa ở bài trước. Thí nghiệm “stock Pi so với Pi cộng custom harness” vẫn là mục tiêu, nhưng nó chưa nên chạy trên một benchmark còn rò rỉ. Danh sách việc phải làm trước:
- Chặn network egress của container trong benchmark runner, chỉ để lại host của LLM API, và chạy lại các task từng tải code upstream để đo độ thổi phồng. Điều này có thể là chặn trực tiếp khả năng chơi trick lỏ của Model :)
- Sửa hai lỗi runner ảnh hưởng tới điểm (phần 4): unstage file trước khi
git checkoutđể test patch áp dụng sạch (sphinx-11510), và sửa nhánh hết ngân sách nudge để agent không bị abort. Kèm theo đó, chạy thử patch chuẩn của từng task ngay lúc import để loại task dữ liệu hỏng thay vì chỉ kiểm hình dạng chuỗi. - Lưu kết quả test trước retry để báo cáo riêng pass ngay lần đầu và pass sau retry; sửa
summary.json(không đếm trùng file-attempt, ghi thời gian gồm cả giai đoạn retry). - Chạy mỗi cấu hình ít nhất 3 lần, và ghi lại provider và quantization của mỗi request (v1 ghim
fp4, từ v2 mình bỏ ghim nên các run có thể chạy trên endpoint khác nhau). - Chỉnh sửa lại skills/tools của harness để có thể gọi được skills và tools khác, và mục đích của mình về upgrade agent harness vẫn đang khá nhiều thứ cần làm. Có thể đây là một lỗi khi chạy trong môi trường sandbox của docker (mình chưa biết).
- Thử một vài benchmark khác: SWE-Bench là một bộ chuẩn mà các công ty AI đang sử dụng và công bố; tuy nhiên mong muốn của mình là thử nghiệm nó trên real task, và có thể giống với công việc hằng ngày; có thể thử riêng một vài benchmark khác để đánh giá công bằng (hoặc xây dựng benchmark của riêng mình :) )
Đừng tin vào số liệu của các công ty AI đưa ra về SWE-Bench hay Terminal Bench, biết đâu họ cũng vô tình (hay là hữu ý) lỡ để cho các con model mình trick lỏ thì sao :)

Leave a comment