
Cuộc thi RSNA Knee Abnormality Detection 2026 trên Kaggle kết thúc vào ngày 22/10. Mình tham gia một mình, bắt đầu khá muộn và làm việc với Claude trong khoảng gần 1 tháng, và kết thúc với public 0.958 / private 0.942, không có medal. Bài này là bản wrap-up: mình đã làm gì, pipeline trông như thế nào, final solution được ghép từ những gì, và quan trọng nhất là tại sao không có medal — thử coi mình sai ở chỗ nào và ngu ở chỗ nào :))
Một điều cần nói trước tiên là toàn bộ model weights trong hai final pick đều là public weights của người khác (nartaa, heliosli, goodpjw2008) vì mình đã cố train những model của riêng mình nhưng không đạt nhiều kết quả tốt. Phần của mình là cách ghép (per-finding routing và rank fusion) và pipeline để chạy các stage public một cách an toàn, và một lần retrain recipe S6 ở tuần cuối. Model của chính mình dừng ở public 0.941 (EXP-074) và private 0.925 (EXP-071 / 076). Phần lớn bài này xoay quanh khoảng cách đó.
Các bạn có thể xem qua thử code của mình trên GitHub tại đây; toàn bộ notebook, model và weights trên Kaggle cũng đã để public (danh sách ở cuối bài).
Tổng quan kết quả
| Public LB | Private LB | |
|---|---|---|
| Final pick 1: EXP-124 — heliosli V2 per-finding weights + goodpjw reader v11 + routing của mình | 0.958 | 0.942 |
| Final pick 2: EXP-127 — EXP-124 + nartaa S6fall ConvNeXt-S ở weight 0.3 trong slot heliosli | 0.958 | 0.942 |
| Best rule-safe (chỉ dữ liệu cuộc thi + public labels + ImageNet backbone): EXP-104 | 0.943 | 0.927 |
| Best chỉ dùng model của mình: EXP-076 / EXP-071 | 0.940 | 0.925 |
| Best public chỉ dùng model của mình: EXP-074 | 0.941 | 0.923 |
| Rank | 571 / 6,425 | 722 / 6,425 |
- 99 experiment id (EXP-000 … EXP-128), 66 submission, 64 được chấm.
- 9 submission cùng hoà ở private 0.942 (EXP-106, 117, 118, 119, 123, 124, 125, 127, 128): cả tuần cuối làm recipe không đổi được gì trên private.
- Theo final report cho Public Leaderboard (LB), ngưỡng silver và bronze trên public lúc kết thúc cũng đúng bằng 0.958, tức điểm của mình.
TL;DR — Pipeline của mình đi từ 0.914 lên 0.941 bằng model tự train, rồi lên 0.958 nhờ ghép các model public lúc đó. Nhưng những lần boost ~+0.02 đó cũng là thứ hàng trăm đội khác có (khoảng 940 đội in ra 0.956 từ cùng bộ weights). Model của mình không đủ mạnh và không đủ khác để thêm đóng góp vào stack public, và từ 15/10 trở đi mọi khác biệt recipe đều nhỏ hơn nhiễu của public split (~0.003). Không có medal vì mình không có “thứ riêng” nào đủ mạnh — không phải vì thiếu experiment.
Bài toán
12 findings, macro AUC
Mỗi study là một ca MRI đầu gối, cần dự đoán xác suất cho 12 finding nhị phân: ACL tear, MCL tear, Medial / Lateral Meniscus tear, Medial / Lateral / Patellofemoral OA, Effusion, Synovitis, Baker’s cyst, Contusion, Fracture. Metric là trung bình 12 ROC AUC (macro AUC), nên finding hiếm cũng nặng như finding phổ biến.
| Train | 4,407 study, 24,371 series (~5.5 series/study, 20–45 slice, median 30), ~570 GB DICOM |
| Test (ẩn) | ~1,300 study, chỉ có ảnh |
| Metadata series | plane (Sag / Cor / Ax), fluid-sensitive, fat-suppression |
Vấn đề label: chỉ có 58 study có real label từ bác sĩ
Đây là điểm đặc biệt nhất của cuộc thi. Chỉ 58 study có nhãn radiologist (mình gọi là “gold-58”: hai bác sĩ MSK đọc, người thứ ba phân xử, trường hợp borderline tính là âm tính). Mọi study còn lại chỉ có report dạng free-text (9+ ngôn ngữ), nên cả field đều train trên soft label rút ra từ report, phần lớn bằng LLM đưa ra dự đoán.
Gold-58 còn không phải mẫu ngẫu nhiên: ACL prevalence 41% so với ~20% trong toàn bộ corpus, mọi study gold đều có ít nhất một finding dương, và vài finding có rất ít ca dương (MCL 9, Lateral OA 11, Baker’s 12). Với 9–35 ca dương mỗi finding, gold-58 không xếp hạng được recipe — nhiễu cỡ ±0.02. Chuyện này sẽ quay lại nhiều lần trong bài.
Giới hạn của code competition
- Notebook chạy tối đa 9 giờ, tắt internet, output
submission.csv. - 5 submission/ngày, chọn 2 final pick.
- Luật quan trọng: được dùng LLM API thương mại để rút nhãn (discussion 733965); dữ liệu ngoài được dùng nếu miễn phí và truy cập được mà không cần ký duyệt của tổ chức (host ruling, discussion 741819, ngày 21/09); KneeCoT bị cấm rõ ràng.
Leaderboard là một “mục tiêu di động”: ngày 28/09 top 1 đã là 0.960 và khoảng 200 đội đứng ở 0.941 nhờ fork cùng một public ensemble; ngày 11/10 có 5,726 đội, bronze (top 10%, hạng 572) là 0.950 và silver (hạng 286) là 0.954; ngày 14/10 cả hai vạch silver và bronze cùng ở 0.956, với 719 đội hiện 0.956.
Hành trình: ba giai đoạn
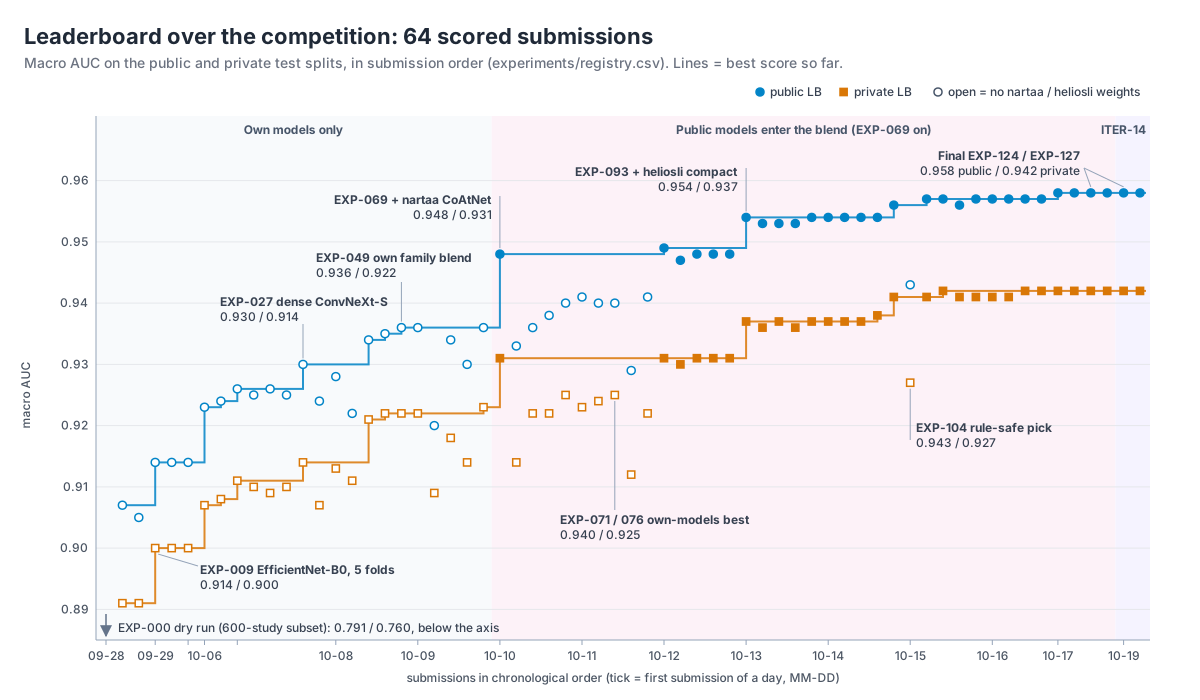 Hình 6. Public / private LB của 64 submission được chấm, theo thứ tự submit; đường là điểm tốt nhất tới thời điểm đó. Vùng đầu là model của mình, từ EXP-069 có public models trong blend, cuối cùng là ITER-14.
| Ngày | EXP | Nội dung | Gold-58 | Public | Private |
|---|---|---|---|---|---|
| 28/09 | EXP-000 | Dry run: EffNet-B0 fold 0 trên subset 600 study | 0.7711 | 0.791 | 0.760 |
| 29/09 | EXP-009 / 012 | EffNet-B0 5 fold, rank-average; stream inference | 0.8928 | 0.914 | 0.900 |
| 07/10 | EXP-020 | ConvNeXt-S @288 5 fold | 0.9007 | 0.926 | 0.911 |
| 07/10 | EXP-027 | ConvNeXt-S, dense cache 88 slice, 5 fold | 0.9104 | 0.930 | 0.914 |
| 08/10 | EXP-049 | ConvNeXt 5f + Raptor + reader + CoAtNet | 0.9172 | 0.936 | 0.922 |
| 10/10 | EXP-069 | Blend đầu tiên với nartaa 0.949 (0.65 nartaa + 0.35 của mình) | 0.9271 | 0.948 | 0.931 |
| 10/10 | EXP-071 | Blend rule-safe của mình | 0.9199 | 0.940 | 0.925 |
| 11/10 | EXP-074 | Raptor v2 96-slice của mình, 2 seed all-data | 0.9206 | 0.941 | 0.923 |
| 13/10 | EXP-093 | nartaa 0.7 + heliosli compact ConvNeXt-S 0.3 | 0.9313 | 0.954 | 0.937 |
| 14/10 | EXP-103 | nartaa (384 + 224) 0.5 + heliosli R7 0.5 | 0.9365 | 0.956 | 0.941 |
| 15/10 | EXP-104 | Rule-safe: seed 96-slice + reader của mình + goodpjw reader | 0.9243 | 0.943 | 0.927 |
| 15/10 | EXP-105 | Per-finding routing nartaa vs R7 | 0.9404 (*) | 0.957 | 0.941 |
| 16/10 | EXP-117 | Routing với heliosli R6 + flip TTA | — | 0.957 | 0.942 |
| 17/10 | EXP-124 | heliosli V2 weights + goodpjw v11 + routing của mình | 0.939 (**) | 0.958 | 0.942 |
| 18/10 | EXP-126 | + heliosli compact-v1 S6 cạnh R6 | — | timeout > 9 h | — |
| 19/10 | EXP-127 | EXP-124 + nartaa S6fall 0.3 | 0.939 | 0.958 | 0.942 |
| 19/10 | EXP-128 | EXP-127 với S6fall s42 + s43 mình retrain | — | 0.958 | 0.942 |
(*) in-sample, vì routing được chọn trên chính gold-58. (**) gold “stand-in”: nartaa in-sample, R7 + flip đứng thay cho R6.
Giai đoạn 1 (28/09 → 11/10) — pipeline của mình, 0.914 → 0.941. Baseline EfficientNet-B0, tăng tốc inference, chuyển sang ConvNeXt-S @288, cache dày hơn, rồi reproduce hai recipe public (Raptor của dreaddevelopment và reader của goodpjw2008) để có đa dạng family, cuối cùng là recipe non-OAI của nartaa trên cache 96 slice. Song song là vài vòng pseudo-label.
Giai đoạn 2 (09/10 → 18/10) — thử sửa public model, 0.948 → 0.958. Ngày 09/10 mình quyết định làm “option B — OAI fallback blend”: EXP-069 = 0.65 × CoAtNet 0.949 của nartaa (train có OAI; source đã được kiểm tra, checkpoint kiểm sha256) + 0.35 × blend EXP-055 của mình. Lúc đó host chưa trả lời về weights dẫn xuất từ OAI (thread 743416), nên plan là chỉ dùng nó làm final pick dự phòng nếu host cho phép, và giữ blend tốt nhất của mình làm pick rule-safe còn lại. Ngày 11/10 (ITER-12) mình kết luận OAI hợp lệ theo host ruling 741819 — vẫn còn rủi ro vì host chưa nói “yes” rõ ràng cho chính OAI. Từ đó: blend neo vào nartaa (12/10), thêm heliosli (13/10), R7 có fastMRI auxiliary (14/10, mình chấp nhận rủi ro luật), routing (15/10), R6 + flip (16/10), per-finding weights của heliosli (17/10). Hai family mới của mình (DINOv2, RadImageNet) không đem lại kết quả tốt trong 16–17/10.
Giai đoạn 3 (18/10 → 19/10) — ITER-14. Build px cache S6 trên Kaggle, retrain ConvNeXt-S seed 43 trên một RTX 4090. Kết quả: giữ nguyên 0.958 / 0.942.
Thứ hạng LB theo thời gian: ~2,600 / 5,550 (09/10) → ~2,300 / 5,726 (11/10) → 282 / 5,953 (14/10) → 240 / 6,013 (15/10, lúc đó vạch silver là hạng 300) → 571 / 6,425 lúc kết thúc. À mình đã nghĩ ra một vài trò có thể blend hoặc fusion một vài prediction cuối cùng (và chắc mẩm là nó đủ tốt :( )
Pipeline của mình
Phần này mô tả hệ thống mình tự xây ở giai đoạn 1. Nó không nằm trong final pick, nhưng là phần mình học được nhiều nhất.
Data: từ 570 GB DICOM đến cache uint8
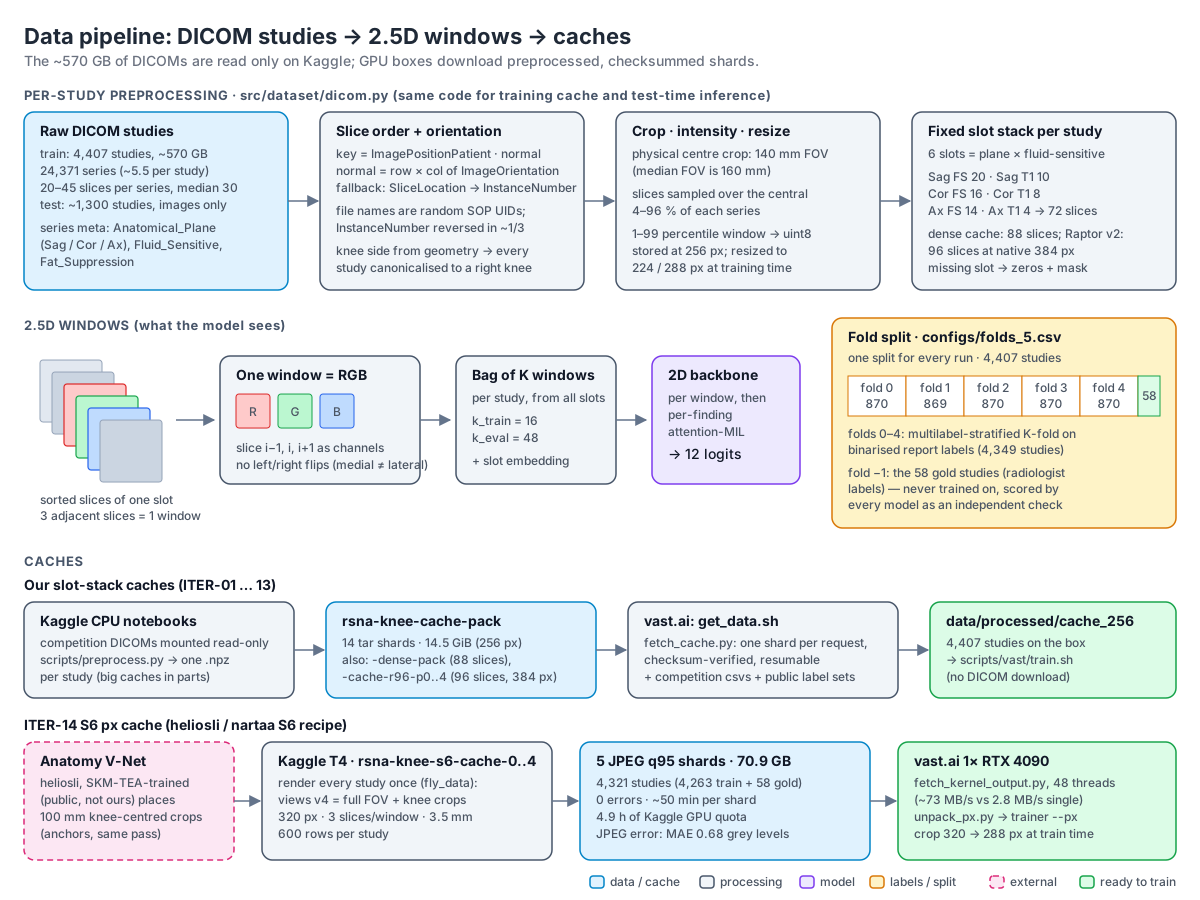 Hình 1. Data pipeline: DICOM → sắp slice, chuẩn hoá về gối phải, crop 140 mm, window 1–99% → cache uint8 dạng shard build trên Kaggle → fold split cố định.
Vài chi tiết nhỏ nhưng tốn thời gian:
- Thứ tự slice phải sắp theo
ImagePositionPatient · normal. Tên file là UID ngẫu nhiên, cònInstanceNumberbị đảo ngược ở khoảng 1/3 số series. - Chuẩn hoá về gối phải (mirror gối trái), crop vật lý 140 mm, window percentile 1–99% theo từng series, lưu uint8.
- Mỗi study thành một stack 6 slot × 72 slice × 256² (slot = plane × fluid-sensitive hay không).
- Không bao giờ tải 570 GB DICOM về máy GPU. Cache được build trong notebook Kaggle miễn phí (CPU/GPU), chia shard vì output notebook giới hạn 20 GB, rồi kéo về box vast.ai dưới dạng tar shard có checksum.
Qua thời gian mình build tổng cộng sáu loại cache:
| Cache | Hình học | Dung lượng | Build |
|---|---|---|---|
cache_256 (EXP-001) |
72 slice (sag-FS 20 / sag 10 / cor-FS 16 / cor 8 / ax-FS 14 / ax 4), 256 px | 14.48 GiB, 14 shard | Kaggle CPU ~2 h |
cache_256_dense (EXP-023) |
88 slice (26/14/20/10/14/4) | 17.83 GiB, 18 shard | Kaggle CPU ~2–2.5 h |
cache_336_raptor |
80 slice, 140 mm @336, không canonicalise | ~40 GB, 3 phần | Kaggle CPU |
| reader cache | theo series, ≤ 64 slice native, @280 | ~35 GB, 4 phần | Kaggle CPU |
cache_384_d96 (EXP-066) |
96 slice (26/22/18/12/18), native 384 px | ~44 GB, 5 phần | Kaggle CPU |
| S6 px cache (ITER-14) | renderer của heliosli, 320 px, + SKM-TEA anatomy V-Net | 70.9 GB JPEG q95, 5 shard, 4,321 study, 0 lỗi | Kaggle T4, 4.9 h quota |
Khi đo lại cache, mình thấy những kết quả mà mình ban đầu không để ý: 33% study có slice trùng liên tiếp trong sag-FS, 44% study có slot với ≥ 2 series ứng viên (mình lấy series đầu tiên theo thứ tự CSV), và 223 study (5%) dùng chung một report template giống hệt nhau. À mà thật ra mình cũng bỏ qua không nghĩ tới nhiều :))
Labels: report → LLM → soft labels
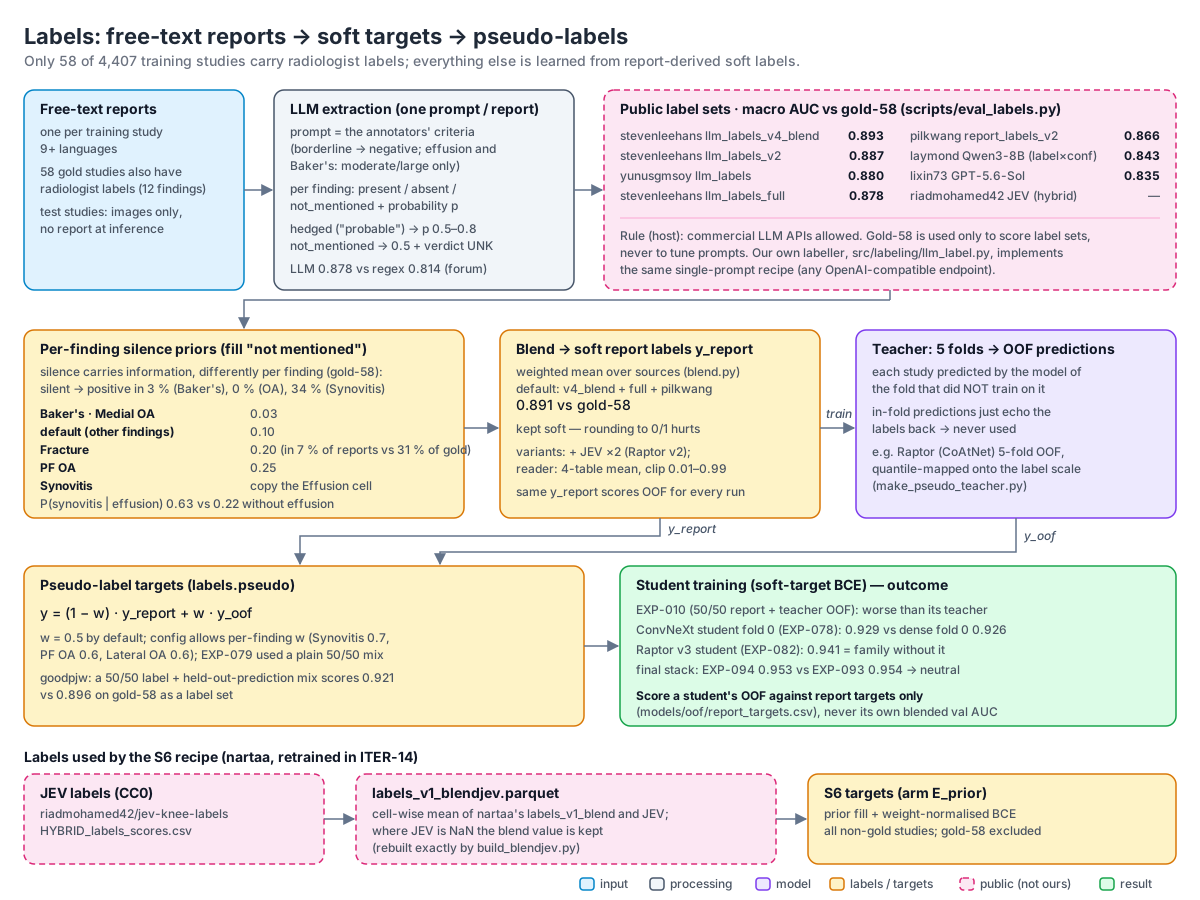 Hình 2. Từ report free-text đến target: các bảng nhãn LLM public → silence prior theo finding → blend soft label → (vòng student) trộn với OOF của teacher.
Mình không tự chạy LLM để rút nhãn — registry không có run nào như vậy (code labeller OpenAI-compatible có sẵn trong repo nhưng không dùng). Target mặc định là blend đều ba bảng public:
| Nguồn | AUC so với gold-58 |
|---|---|
stevenleehans v4_blend |
0.893 |
stevenleehans full |
0.878 |
pilkwang report_labels_v2 |
0.866 |
| Blend đều (default) | 0.8911 |
Report thường “không nhắc tới” một finding nào đó (giá trị 0.5). Mình điền bằng silence prior riêng cho từng finding: mặc định 0.10; Synovitis lấy theo Effusion (P(syn | eff) = 0.63 so với 0.22); PF OA 0.25; Fracture 0.20; Baker’s 0.03; Medial OA 0.03. Nhãn giữ dạng soft. Recipe Raptor v2 thêm bảng JEV của riadmohamed42 với weight 2; recipe reader dùng trung bình 4 bảng public, clip 0.01–0.99.
Pseudo-label dùng OOF của teacher: lần đầu (EXP-010, 50/50 với OOF EffNet của chính family đó) tệ hơn hẳn (OOF 0.845 so với 0.865). Lần sau dùng teacher khác kiến trúc (Raptor repro 5 fold, quantile-mapped) cho ConvNeXt student: pooled OOF 0.8869 so với 0.8781, LB fold 0 0.929 so với 0.926 — có tăng, nhưng gold giảm nhẹ (0.9044 so với 0.9100) và nó không đẩy được stack cuối (EXP-094 0.953 so với EXP-093 0.954). Một quy tắc mình phải ghi thành luật: không bao giờ so val metric của student với của teacher, mà luôn chấm OOF so với report_targets.csv.
Model: 2.5D windows + per-finding attention MIL
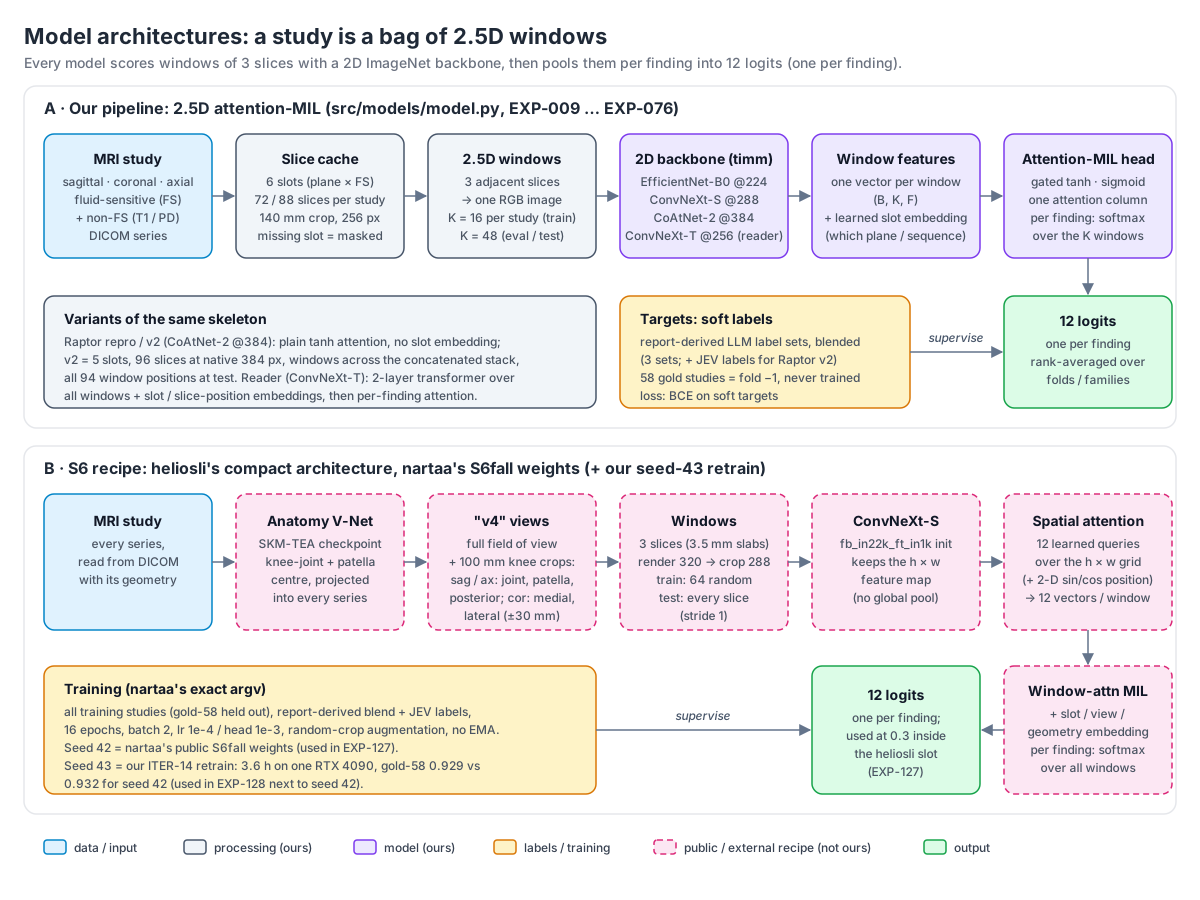 Hình 4. Panel A — KneeMILModel: bag các window 3 slice liền kề (thành RGB) → timm backbone → slot embedding → attention pooling riêng cho từng finding → 12 logit. Panel B: recipe S6 (ConvNeXt-S, full FOV + crop 100 mm quanh gối do SKM-TEA V-Net định vị).
Kiến trúc chung (KneeMILModel):
- 2.5D: ba slice liền kề ghép thành một ảnh RGB, nên dùng thẳng được ImageNet backbone của
timm. - Mỗi study là một bag các window; train lấy 16 window, eval lấy 48.
- Cộng slot embedding để model biết window đến từ plane / sequence nào.
- Gated attention-MIL riêng cho từng finding: mỗi finding tự chọn window nào quan trọng (ACL nhìn sag, MCL nhìn cor…).
- Không flip trái/phải khi augment, vì medial vs lateral chính là tín hiệu.
Các family mình đã train:
| Family | Recipe | Kết quả chính |
|---|---|---|
| EfficientNet-B0 @224 → ConvNeXt-S @288 → ConvNeXt-S dense | cùng pipeline; dense = cache 88 slice | 5 fold: LB 0.914 → 0.926 → 0.930 |
| CoAtNet-RMLP-2 @384 | recipe của mình | fold 0: LB 0.924 |
| Raptor repro | recipe dreaddevelopment: CoAtNet-2 @384, tanh-MIL, cross-slot window, pos_weight BCE, OneCycle | fold 0: OOF 0.8770, LB 0.928 |
| Reader repro | recipe goodpjw: ConvNeXt-T + slot/position embedding + transformer MIL 2 lớp, EMA 0.998 | member ít tương quan nhất (rank corr 0.874–0.888) |
| Raptor v2 d96 | recipe non-OAI của nartaa trên code của mình, cache 96 slice native-384, 94 window + mirror TTA | 1 seed 0.938, 2 seed 0.941 |
| DINOv2-S, RadImageNet R50 | trên cache d96 | gold DINOv2 0.841 / 0.864 (hai biến thể), RadImageNet 0.842, so với gate 0.914 → negative |
Training và workflow
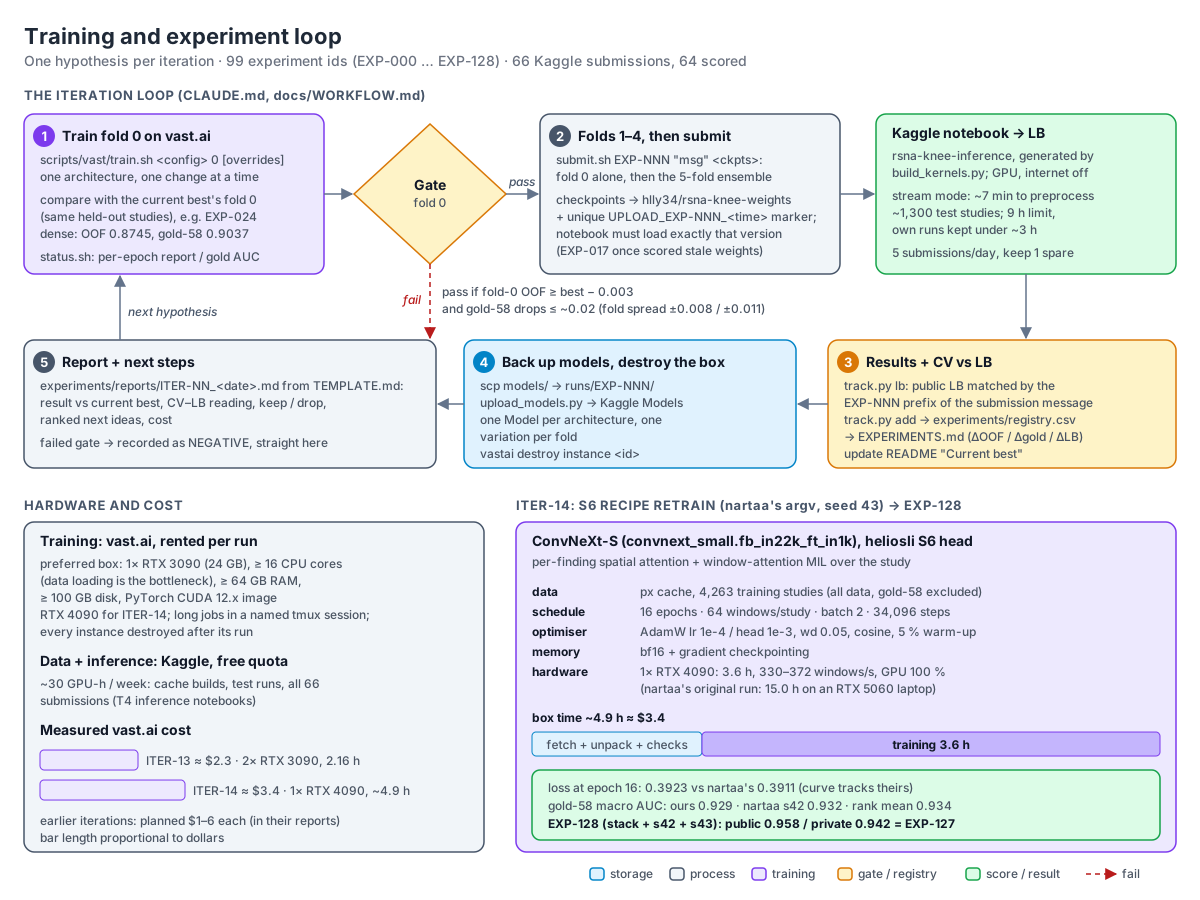 Hình 3. Vòng lặp iteration: train fold 0 trên vast.ai → gate so với fold 0 của best → submit trên Kaggle → cập nhật registry và CV–LB → backup model → report. Nhánh dưới: ITER-14 retrain S6.
Mọi run dùng một fold split duy nhất (configs/folds_5.csv), gold-58 là fold −1 (tức tách riêng làm holdout, không thuộc fold nào) và không bao giờ được train. Các run “all-data” thì train trên cả 5 fold, và chỉ còn gold-58 để chấm. Default: batch 8, 15 epoch, lr 3e-4 (backbone ×0.1), wd 0.02, cosine + 1 epoch warm-up, 16-mixed, gradient clip 1, và average weights của top-3 epoch mỗi fold. Lúc inference rank-average tất cả model của các fold.
Mỗi thay đổi đi qua vòng lặp ở Hình 3. Gate của bước 1: fold-0 OOF ≥ best − 0.003 và gold không giảm quá ~0.02; không qua thì ghi NEGATIVE và đi thẳng tới report. Spread giữa các fold là ±0.008 OOF / ±0.011 gold, nên chỉ so cùng fold hoặc pooled OOF. Mỗi submission message bắt đầu bằng EXP-NNN để track.py lb match LB về registry.
Phần cứng: phần lớn run trên vast.ai 1× RTX 3090 (≥ 16 core — data loading (CPU decode + augment cache) mới là bottleneck lúc train, không phải GPU), có lúc 2× 3090 chạy song song, ITER-14 dùng 1× RTX 4090. Kaggle T4 cho một số run fold 0 và toàn bộ inference. Thời gian train mỗi fold trên 3090: EffNet-B0 ~37 phút, ConvNeXt-S @288 87–107 phút, CoAtNet 177 phút, reader 145 phút, Raptor repro ~258 phút, Raptor v2 d96 all-data ~255 phút.
Inference là chỗ mình đầu tư sớm và đáng: stream mode (chỉ decode pixel của slice được sample, đọc header cho tất cả; đọc thread; overlap CPU/GPU; một lần duyệt dữ liệu cho mọi checkpoint) đưa thời gian từ 1.23 xuống 0.34 s/study, ~7.3 phút preprocessing cho 1,300 study. EXP-012 chấm xong trong ~11 phút. Nhưng khi stack lớn dần, runtime phình theo: EXP-071 ~8.75 h (bảy member có mirror TTA), EXP-118 7 h 16 phút, EXP-124 ≈ 5 h, và EXP-126 vượt 9 h.
Final solution
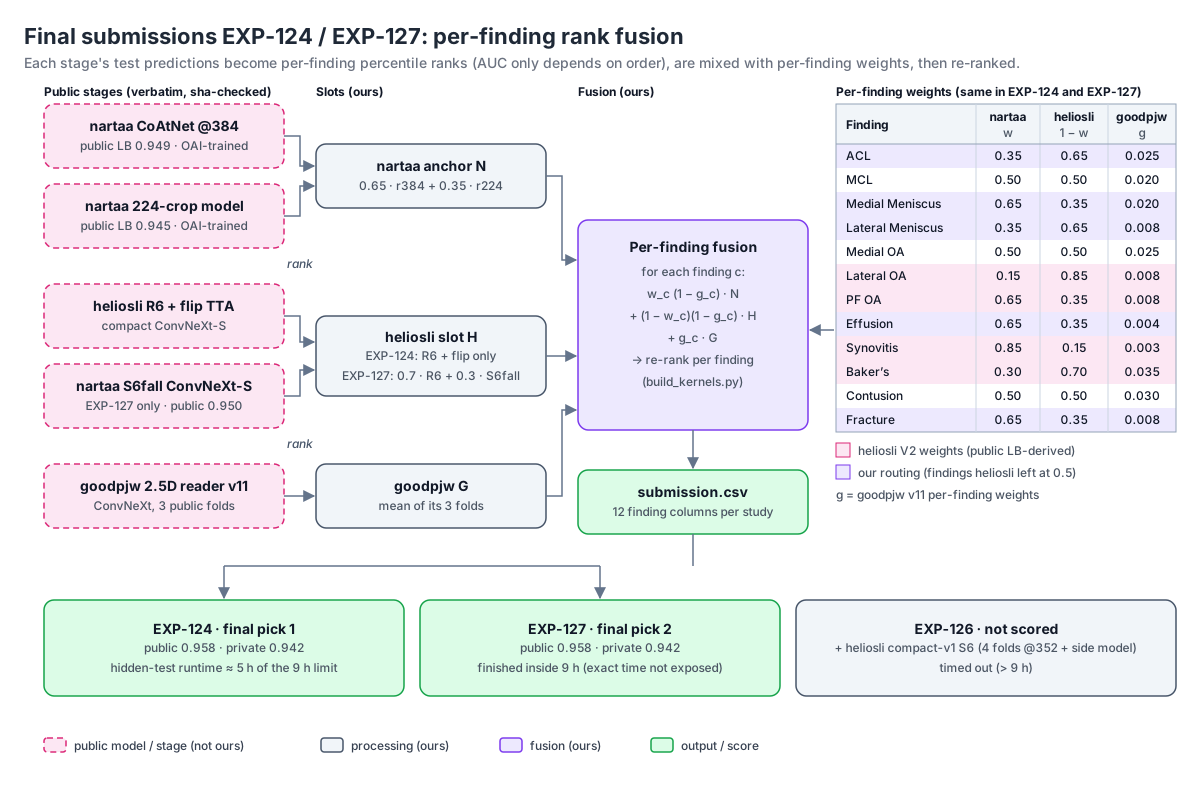 Hình 5. Final blend EXP-124 / EXP-127: các stage public (nartaa, heliosli, goodpjw, và S6fall ở EXP-127) → percentile rank theo từng finding → fusion có trọng số riêng cho từng finding → re-rank → submission.
Cái gì là public, cái gì là của mình
| Thành phần | Của ai |
|---|---|
| CoAtNet “Raptor ft” 0.949 (train trên OAI) + model 224-crop 0.945; slot nartaa = 0.65 × 384 + 0.35 × 224 | nartaa (weights + inference cell) |
| Compact ConvNeXt-S R6 (fastMRI auxiliary) + flip TTA | heliosli |
| Per-finding weights “V2” cho Synovitis, Lateral OA, PF OA, Baker’s | heliosli (rút từ LB) |
| 2.5D ConvNeXt reader, 3 fold, weights v11 | goodpjw2008 |
S6fall ConvNeXt-S (E_prior_s42_fall.pt, public 0.950 khi đứng riêng) — chỉ EXP-127 |
nartaa |
| SKM-TEA anatomy checkpoint cho crop S6 | heliosli |
| Per-finding routing nartaa vs heliosli cho ACL, Lateral / Medial Meniscus, Effusion, Fracture | mình |
| Rank fusion theo finding, stage plumbing verbatim + sha256 check, stage generator S6 | mình |
| ITER-14: px cache S6 + retrain seed 43 (EXP-128, không phải final pick) | mình, theo recipe của nartaa |
Mỗi stage là bản copy nguyên văn cell của một notebook public đã được chấm, weights được kiểm sha256, và không re-host weights của ai. Mình reproduce từng con số public trước khi đưa nó vào blend.
Per-finding rank fusion
Mỗi stage cho prediction → đổi sang percentile rank theo từng finding (tuỳ chọn probit) → cộng có trọng số:
fused = w·nartaa + wh·heliosli + wg·goodpjw + (1 − w − wh − wg)·ours
rồi re-rank lại. Ở EXP-123/124, share là nartaa = wr(1 − g), heliosli R6 = (1 − wr)(1 − g), goodpjw = g. Theo công thức đó thì checkpoint của chính mình mang weight 0 trong final pick — mình đọc như vậy từ công thức, và nó khớp với việc model của mình không còn thêm được gì (phần sau). Ở EXP-127, slot heliosli là 0.7 × R6 + 0.3 × S6fall.
Bảng weight đầy đủ nằm trong Hình 5. Tóm tắt share của nartaa (wr): heliosli V2 đặt Synovitis 0.85, Lateral OA 0.15, PF OA 0.65, Baker’s 0.30; routing của mình (từ EXP-117) đặt ACL / Lateral Meniscus 0.35 và Medial Meniscus / Effusion / Fracture 0.65; MCL, Medial OA, Contusion giữ 0.5. Share g của goodpjw chỉ từ 0.003 (Synovitis) đến 0.035 (Baker’s).
Hai cái mình muốn nói. Thứ nhất, ở PF OA và Baker’s, routing của mình và của heliosli ngược chiều nhau; mình giữ của heliosli vì nó rút từ LB, còn của mình rút từ gold-58 in-sample. Thứ hai, gold sanity check: để tất cả 0.5 → 0.935; EXP-117 0.940; EXP-119/123 0.937; EXP-124 0.939 — các khác biệt đều nhỏ hơn bootstrap SD ±0.014 của gold, tức là gold không phân biệt được chúng. Ngày 17/10, cả bốn EXP-119/123/124/125 đều hiện 0.958; trên điểm chưa làm tròn ở trang submission thì EXP-124 > EXP-125, nên lúc đó pick 1 là EXP-124 (backup EXP-125).
Pick 2: từ rule-safe sang EXP-127
Luật chọn pick mình đặt ngày 14/10: pick 1 lấy điểm cao nhất với bất kỳ public weights nào, pick 2 lấy bản chỉ dùng dữ liệu cuộc thi + public labels + ImageNet backbone, để phòng trường hợp OAI/fastMRI bị loại. Đến 17/10, pick 2 vẫn là EXP-104 rule-safe (0.943 / 0.927). Hai final pick cuối cùng là EXP-124 và EXP-127; Lý do mình chọn là vì tới ngày cuối mà ban tổ chức vẫn im ắng thì mình liều thôi :)). Về kết quả: EXP-104 private 0.927, cả hai pick đều 0.942.
ITER-14: retrain S6 của nartaa
Tuần cuối, nartaa chia sẻ trong discussion 749359 rằng S6 ConvNeXt của heliosli, retrain trên label của họ, cho 0.950 khi đứng riêng, kèm trainer Apache-2.0. Plan ban đầu (18/10) là train DINOv2 ViT-B với trainer đó; cùng ngày mình đổi sang ConvNeXt-S, đúng argv của nartaa, seed 43, để reproduce kết quả ConvNeXt-S all-data tốt nhất trong discussion post. Mình vendor trainer vào repo và làm lại:
- S6 =
convnext_small.fb_in22k_ft_in1k, spatial attention theo finding + window-attention MIL; view = full FOV + crop 100 mm quanh gối do SKM-TEA anatomy V-Net định vị; 320 px → crop 288; 64 window/study, 16 epoch, AdamW lr 1e-4 / head 1e-3, batch 2, bf16. - Cache: pilot 50 study 0 lỗi, nhưng dự kiến 71.7 GB thay vì 15–25 GB mình ước tính, vì các row ảnh MRI chỉ nén được ~3.4× (không phải ~10×). Full 4,321 study: 70.9 GB, 5 shard, 0 lỗi, 4.9 h quota T4. Sai số JPEG MAE 0.68 mức xám.
- Train: 1× RTX 4090, 16 epoch, 34,096 step, 3.6 h (nartaa chạy 15.0 h trên RTX 5060 laptop), loss bám sát run của nartaa (epoch 16: 0.3923 so với 0.3911). Tải output Kaggle bằng
kaggle kernels outputchỉ 2.8 MB/s; fetcher 48 thread tự viết lên ~73 MB/s. Chi phí ≈ $3.4. - Gold-58: s43 của mình 0.929, s42 của nartaa 0.932, rank mean cả hai 0.934. Weights để ở dataset Kaggle
hlly34/rsna-knee-s6-cnx-s43(CC BY-NC 4.0). - Kết quả: EXP-128 = 0.958 / 0.942, giống hệt EXP-127, dù output S6 với s43 khác EXP-127 tới 0.11 ở một số prediction.
Tại sao không có medal
Đây là phần mình muốn share có thể là cho sau này mình tránh gặp lại.
1. Sử dụng public model và tinh chỉnh nó không đem lại nhiều cơ hội cho mình - vì ai cũng có thể làm và có khi tốt hơn
Từ 0.941 (model của mình) lên 0.958, gần như toàn bộ ~+0.02 đến từ public models — nartaa 0.949, heliosli, goodpjw. Đó cũng chính là bộ mà mọi đội top dùng: ITER-12 ghi nhận cả 50 public notebook top (0.950–0.954) đều gắn weights OAI của nartaa, và theo phân tích của leoprovorov, khoảng 940 đội in ra 0.956 từ cùng bộ weights.
Mình vào stack này khá muộn: blend nartaa đầu tiên 10/10, heliosli 13/10, R7 14/10. Cách mình đọc: tới lúc đó hàng trăm đội đã có cùng nguyên liệu, và thứ duy nhất còn khác nhau là per-finding weights — nằm trong nhiễu (mục 3). Nên nếu không ngoan hơn mình nên reproduce lại public model và đi tiếp với những thứ khác, thay vì chỉ blend và mong chờ 1-2 thứ phép màu không có thật.
2. Model của mình không thêm gì vào stack public
Đây có thể là vấn đề về sự đa dạng trong solution, nếu dùng stack public model thì chúng ta nên đưa vào stack đó những solution mới hơn: model, backbone, approach training khác hẳn, …
Model của mình đỉnh ở 0.941 public / 0.925 private — còn thấp hơn một model public đơn lẻ (CoAtNet 0.949 của nartaa). Và khi thêm vào stack, chúng trung tính hoặc làm giảm nhẹ:
| Thử nghiệm | Public | So với |
|---|---|---|
| nartaa đứng riêng | 0.949 | — |
| EXP-069: 0.65 nartaa + 0.35 của mình | 0.948 | 0.949 |
| EXP-083..086: thêm model của mình vào nartaa | 0.947–0.948 | 0.949 |
| EXP-093: nartaa + heliosli | 0.954 | — |
| EXP-094..096: + model của mình | 0.953 | 0.954 |
Như final report viết: public partner models làm điểm di chuyển; model của mình thì không, một khi đã có model của nartaa. Lý do khá rõ: family 96-slice tốt nhất của mình chính là recipe của nartaa, chỉ thiếu OAI, nên nó tương quan rất cao với anchor. Mình đã copy recipe tốt nhất — và vì copy, nó không đem lại gì khác. Khoảng cách non-OAI cũng chưa bao giờ thu hẹp được: recipe non-OAI của nartaa đạt 0.942 không mirror TTA (test time augmentation), bản replica của mình 0.938 có mirror TTA. Mình đã nghĩ là do label của họ có OAI dataset và chi tiết training, nhưng không tìm ra chính xác lý do để cải thiện.
3. Từ 15/10, mọi khác biệt nằm dưới nhiễu — và mình stuck ở đây
Public split có khoảng 640 study, nên SD của score chỉ do sampling đã là ~0.003 — lớn hơn cả spread của top 400 đội (0.0022). Mọi thay đổi recipe mình thử từ 15/10 đều nhỏ hơn con số này: routing +0.001, flip TTA, per-finding weights, S6fall, S6 retrain. Theo lời final report: từ lúc đó công việc bị giới hạn bởi nhiễu, không phải bởi ý tưởng.
Ngày 15/10 mình ở hạng 240, trên vạch silver (hạng 300). Sau đó mình đứng yên ở 0.957–0.958, còn kết thúc ở hạng 571 / 6,425 — khoảng 330 đội đã vượt lên trong một tuần. Hạng 571 vẫn trong top 10% theo số lượng, và vạch silver/bronze public lúc kết thúc đúng bằng 0.958. Cách mình đọc: mình ngồi trên vạch trong một khối rất nhiều đội cùng điểm, và private quyết định phần còn lại. Với Private Leaderboard thì hoàn toàn tụt xa khoảng >150 rank và ra khỏi top có huy chương đồng.
4. Gold-58 quá nhỏ để làm thước đo cuối
| Thước đo | Độ tin cậy |
|---|---|
| OOF vs report labels | nhiễu ~0.003; Pearson với LB 0.977 (19 điểm), Spearman 0.758 |
| Gold-58 | bootstrap SD ±0.014; Pearson với LB 0.988 (39 điểm) nhưng chủ yếu nhờ range rộng — 0.74 trong vùng cạnh tranh (gold ≥ 0.895, 14 điểm) |
Gold-58 tốt để loại một thứ hỏng (DINOv2 0.841 so với 0.914 là quá rõ), nhưng vô dụng để chọn giữa hai blend sát nhau. EXP-076 tune weights trên gold đạt gold 0.9259 nhưng LB 0.940 — bằng EXP-071 không tune. Gold cũng không xếp hạng được các blend neo vào nartaa, và weights tune trên gold của goodpjw cũng thua trên board (0.957 / 0.955 so với 0.958). Vậy mà routing của mình trong final pick (ACL, meniscus, Effusion, Fracture) vẫn được chọn trên gold-58 in-sample — một phần lý do nó chỉ đáng +0.001.
Mình cũng nghĩ chúng ta nên chỉ sử dụng Gold-58 để đánh giá tính khả thi của 1 model LLM để tạo soft-label; tức là dùng nó để dự đoán population từ sample; thay vì đánh giá cả một model huấn luyện cho dù nó có correlation với các kết quả trên LB khá tốt.
5. Thời gian đổ vào chỗ không tạo khác biệt
Mình có thể kết luận rằng label là nút thắt của cuộc thi này. Nhìn lại, mình gần như không đầu tư trực tiếp vào label: không có run LLM label riêng, không có run lọc label noise. Các mục trong queue ITER-05 như MixUp, flip kèm hoán đổi nhãn medial/lateral, noise filtering, sequence head (EXP-030..036) không xuất hiện trong registry, tức là chưa từng chạy. Phần lớn tăng trưởng của model mình đến từ việc copy recipe public (Raptor, reader, data 96 slice của nartaa).
Trong khi đó, khá nhiều thời gian và GPU đi vào các nhánh negative: DINOv2 / RadImageNet, vài vòng pseudo-label không cải thiện được vì teacher model đã kém, reader v2 / v3 thay đổi architecture, ConvNeXt-d96, kiểm tra all-windows / forced mirror TTA. Mỗi cái đều nhỏ, nhưng gộp lại chúng rải suốt 10/10 → 17/10 — đúng giai đoạn mà, nhìn lại, cần dành cho một solution mới hơn để bứt phá và có thể blend với các public model.
6. Những thứ còn lại mà mình không làm để cải thiện
- Train một model OAI của riêng mình (ước tính 4–6 ngày) — không làm. Vì mình nghĩ dữ liệu này cần thêm rất nhiều thời gian để phân tích.
- Merge team trước hạn 15/10 — đã cân nhắc, không làm. Chắc model base mình tự train cùi quá không dám đi năn nỉ ai cho vô team :))
- Thêm seed / label set khác cho recipe S6 trên cache đã build, flip TTA cho S6, một backbone mạnh hơn trên cache 96 slice — hết thời gian.
Tóm lại, theo mình: không có medal không phải vì thiếu experiment, mà vì không có một thành phần riêng nào đủ mạnh và đủ khác để vượt đa số các đội chung public weights. 99 experiment chủ yếu là tinh chỉnh quanh cùng một nguồn tín hiệu duy nhất và nó không có thay đổi được kết quả.
Những gì work / không work
Work
Ngoài backbone (EffNet-B0 → ConvNeXt-S, +0.012 LB), stream inference và per-finding routing (+0.001) đã nói ở trên:
| Thay đổi | Hiệu quả |
|---|---|
| Dense cache 88 slice | +0.0017 OOF, +0.010 gold, LB 0.926 → 0.930; Lateral Meniscus gold fold 0 0.808 → 0.842 |
| Đa dạng family (ConvNeXt + Raptor + reader, fold 0) | +0.008 CV / +0.012 gold, LB 0.934 so với single tốt nhất 0.928; EXP-049 0.936 |
| Recipe non-OAI của nartaa + cache 96 slice native-384 | all-data Raptor 0.930 → 0.933 (recipe) → 0.938 (cache); 2 seed 0.941 |
| Mirror TTA | 9/9 family đủ điều kiện tăng trên gold (+0.0006 đến +0.0032); ~+0.0002 trong blend |
Không work
Ngoài những thứ đã nói ở trên (model của mình trong stack public, tune trên gold, DINOv2 / RadImageNet, S6fall):
| Thử nghiệm | Kết quả |
|---|---|
| EXP-010 pseudo-label 50/50 với teacher cùng family | OOF 0.845 so với 0.865 |
| EXP-016 thêm window lúc eval (48 → 64); all windows cho ConvNeXt/CoAtNet | trung tính |
| EXP-022 blend ConvNeXt + EffNet | 0.925 so với 0.926 |
| EXP-056 reader v2 trên label của mình; EXP-053 reader v3 | CV tăng nhưng LB 0.920 so với 0.922; v3 không tăng |
| EXP-059 all-data Raptor trong blend; EXP-070 reader seed 2 | 0.936 = 0.936 |
| EXP-073 ConvNeXt-S với recipe v2 tune cho CoAtNet; EXP-080 ConvNeXt trên native cache | gold 0.896; OOF −0.010, gold −0.014 |
| Forced mirror trên model đã canonicalise | CoAtNet −0.0065, ConvNeXt −0.0038 gold |
| EXP-081 / 082 Raptor v3 pseudo student | gold 0.9133 so với 0.9142; LB 0.941 = EXP-074 |
| Probit fusion, routing Lateral OA sang reader của mình, goodpjw trên hai finding, heliosli 0.4 (EXP-097..101) | đều 0.954 |
| EXP-107 routing mạnh hơn (0.8 / 0.2) | 0.956 so với 0.957 |
| EXP-118 thêm R7 cạnh R6 | không tăng, +2 h runtime |
Bài học và kinh nghiệm
Process
- Một fold split, một holdout cố định, một registry. Nhờ vậy 99 experiment so được với nhau.
EXP-NNNlà id toàn cục, không tái sử dụng, prefix mọi submission message;registry.csvsinh raEXPERIMENTS.md. Đây là thứ mình sẽ giữ nguyên cho cuộc thi sau. - Gate fold 0 trước khi tốn tiền 5 fold. Rẻ và loại được phần lớn nhánh hỏng.
- Biết threshold của mình nhiễu bao nhiêu — và tính nó trước khi tune. Mình biết gold-58 có SD ±0.014 từ 09/10; EXP-076 là một bài test và nó xác nhận tune trên gold không chuyển sang LB. Vậy mà routing trong final pick vẫn được chọn trên gold in-sample. Biết là một chuyện, chấp nhận dừng lại là chuyện khác vì lúc đó điểm trên Public Leaderboard vẫn đang tăng :)
Tooling
- Kaggle là “nhà máy dữ liệu” miễn phí (xem phần Data). Fetcher song song (
fetch_kernel_output.py) đưa tốc độ tải output từ 2.8 lên 73 MB/s. - Notebook được sinh bằng code (
submission/build_kernels.py), không sửa trên kaggle.com. Code đẩy lên datasethlly34/rsna-knee-code. submit.shcó upload marker duy nhất và kiểm danh sách checkpoint — đã bắt được một notebook chỉ có 4/5 checkpoint trước khi submit.
Những lỗi mình đã mắc
| Sự cố | Chuyện gì xảy ra | Sửa thế nào |
|---|---|---|
| EXP-017 | Chấm trên weights EfficientNet cũ (trùng tên file với version dataset trước) → 0.914 = EXP-009 | Submit lại thành EXP-019 → 0.923; thêm upload marker vào submit.sh |
| EXP-039 | CUDA OOM trên hidden test (CoAtNet @384, 8 study × 24 window trên T4) | Chia batch an toàn, EXP-040 |
| EXP-015 | CoAtNet trên T4 chạm 9 h giữa chừng | Kết quả không kết luận được |
| EXP-071 | Bảy member có mirror chiếm ~8.75 h / 9 h | Chỉ mirror các family được chỉ định |
| EXP-072 | Mất file metrics json (scp fail trước khi auto-destroy) | — |
| heliosli R6 | Dataset v2 âm thầm chứa R7 dưới cùng tên file (Kaggle gắn version mới nhất) | R6 không dùng được tới khi có bản re-publish -w1 |
| EXP-126 | Timeout > 9 h: compact-v1 = 4 fold @352 + side model, nặng ngang R6 | Bỏ; thay bằng S6fall ở EXP-127 (chạy kịp trong 9 h) |
| EXP-127 v83 | Fail vì một JSON null trong stage được sinh tự động (NameError) |
Sửa ở v84 |
| Scheduled submit | Bị treo hai lần (15/10 07:06, 16/10 07:04) | — |
Bài học từ bảng này: phần lớn sự cố nằm ở đường ống, không nằm ở model. Weights cũ, version dataset, timeout, JSON null — đều là những thứ một check tự động rẻ tiền bắt được. Và ở code competition, mỗi lỗi kiểu này tốn nguyên một lượt chạy 5–9 giờ cộng một submission trong ngày.
Nếu làm lại
- Bắt đầu từ stack public mạnh nhất ngay khi nó xuất hiện, reproduce nó, rồi dành phần lớn thời gian còn lại để tìm một solution độc lập — thay vì tự xây lên 0.941 rồi mới thấy một model public đơn lẻ đã là 0.949.
- Đầu tư vào label. Đây là chỗ mình thấy nút thắt, và là chỗ mình làm ít nhất: tự rút nhãn bằng LLM, lọc label noise, xử lý medial/lateral cẩn thận. Tốn thêm tiền và sẽ có phép màu nhiều hơn :)
- Đo độ đa dạng trước khi train. Copy recipe tốt nhất cho ra model tương quan cao với chính recipe đó. Một family mới chỉ đáng giá nếu nó khác.
- Đặt “noise budget” cứng. Khi SD của public split (~0.003) lớn hơn khác biệt mình đang theo đuổi, dừng tinh chỉnh và chuyển sang việc khác.
- Cân nhắc merge team nghiêm túc hơn — một người khác với pipeline khác là cách rẻ nhất để có một solution độc lập với mình hiện tại.
Kết luận
Mình không thất vọng với hệ thống đã xây: pipeline từ DICOM đến submission chạy ổn định, vòng lặp experiment có kỷ luật, 99 experiment so được với nhau, chi phí rất thấp. Nhưng hệ thống tốt không thay thế được việc có một thứ riêng. Medal ở cuộc thi này không đến từ việc ghép public weights khéo hơn người khác 0.001, mà tìm ra dữ liệu soft-label tốt hơn, chiến lược để verify solution tốt hơn; đặc biệt là cần sự đa dạng trong solution.
Credits & links
Cảm ơn những người đã công bố model, code và nhãn — final solution của mình không tồn tại nếu không có họ:
| Ai | Mình đã dùng gì |
|---|---|
| nartaa | CoAtNet 0.949 (OAI) + 0.945 224-crop; S6fall weights + training code (Apache-2.0) và notebook inference S6fall; recipe non-OAI (discussion 749359) |
| heliosli | Notebook 0.957 one-click (per-finding weights), compact ConvNeXt-S, R6 / R7 (+ flip TTA), kiến trúc S6, compact_train.py, SKM-TEA anatomy checkpoint |
| goodpjw2008 | 2.5D ConvNeXt reader (weights + code; mình cũng reproduce recipe) |
| dreaddevelopment | Recipe Raptor (CoAtNet trainer, knee-raptor-corpus) |
| stevenleehans, pilkwang, lixin73, laymond, yunusgmsoy | Các bảng nhãn rút từ report |
| riadmohamed42 | JEV labels |
| rabari9999 | Notebook gốc của các cell reader goodpjw |
| leoprovorov | Phân tích nhiễu public split |
| SKM-TEA, OAI, fastMRI, RSNA | Dữ liệu đằng sau các model public và cuộc thi |
Phần của mình — tất cả đều đã để public:
- Code: toàn bộ pipeline (cache, training, submission builder, registry, report từng iteration) ở GitHub hllj/rsna-knee-abnormality-detection, xây trên template hllj/kaggle-boilerplate. Bản đóng gói cho Kaggle: dataset
hlly34/rsna-knee-code. - Notebook final:
hlly34/rsna-knee-inference(sinh bởisubmission/build_kernels.py; các version cũ là từng submission). - Model: 17 Kaggle Model
hlly34/rsna-knee-*— mỗi family một model, mỗi fold một variation (EfficientNet-B0, ConvNeXt-S, CoAtNet-2, Raptor / reader repro, Raptor v2 d96, DINOv2, RadImageNet…). - Weights:
hlly34/rsna-knee-s6-cnx-s43(S6 ConvNeXt-S seed 43, CC BY-NC 4.0),hlly34/rsna-knee-weights(ConvNeXt-S @288, 5 fold).
Nếu bạn quan tâm phần nào cụ thể, cứ hỏi mình.
Leave a comment