
Agent ngày càng giỏi trong một session. Nhưng một dự án thật kéo dài nhiều session.
Mở đầu: vì sao mình xây dựng wreck-it-ralph#
Anthropic mô tả ba kiểu thất bại trong bài Effective harnesses for long-running agents:
- Làm một lèo cả dự án, hết context giữa chừng, để lại một feature làm dở mà không ai biết.
- Tuyên bố xong quá sớm: có vài feature rồi, agent nhìn quanh thấy đã có tiến triển và kết luận hoàn thành.
- Đánh dấu feature xong khi chưa test đầu-cuối: agent chạy unit test hoặc
curlrồi coi như xong, chưa thử như một người dùng thật.
Claude Code đã giải quyết một phần: CLAUDE.md, auto memory, compaction và --resume để nhớ, subagent để cô lập context, /goal để chạy tới khi một điều kiện thoả. Mình nghĩ nền tảng đã gần đủ, vì người ta có thể thêm rules, hooks và một evaluator độc lập. Repo ví dụ của Anthropic (cwc-long-running-agents) làm đúng vậy, nhưng chính nó tự nhận chỉ là “nguyên liệu ví dụ, không phải harness hoàn chỉnh” và không còn được bảo trì: không có sẵn ngân sách, bộ lập lịch cho nhiều feature hay đường leo thang cho người.
Vậy chỗ nào mình muốn thử thêm? Không phải điều gì quá mới nhưng mình muốn thử đóng gói nó vào trong Claude:
- (1) Thêm một backlog có cấu trúc. Resume mở lại một cuộc hội thoại, không phải danh sách feature kèm trạng thái. Liệu mình có thể tạo một backlog để mỗi session biết tình hình hiện tại, cái nào xong, cái nào đang chờ cái nào ?
- (2) Memory là thứ gợi nhắc, liệu có thể đưa thành luật. Tài liệu của Claude Code nói
CLAUDE.mdvà auto memory là context chứ không phải cấu hình được thực thi; muốn bắt buộc thì phải dùng hook. Liệu mình có thể làm sẵn những luật đó thành gate, để không phải tự viết hook cho từng dự án và khi có những yêu cầu mới ? - (3) Người chấm tách khỏi người viết. Evaluator của
/goallà một model nhỏ chỉ đọc transcript và không chạy công cụ nào. Liệu mình có thể xây những evaluator và gate chặt hơn, có bằng chứng đi kèm ?
Từ ba câu hỏi đó, mình muốn thử một hướng: coi chính vòng lặp là thứ cần thiết kế tức chính là thứ mà dạo gần đây mọi người hay nhắc tới - Loop Engineering. Tiến độ nằm trong file mà gate kiểm tra được, việc kiểm chứng giao cho một agent khác, và luật dừng, khi nào hỏi lại người, hết budget nằm trong script chứ không trong prompt.
Mình xây wreck-it-ralph (github.com/hllj/wreck-it-ralph) theo hướng đó, từ ba ý tưởng có sẵn: harness của Anthropic, Ralph loop của Geoffrey Huntley, và ý tưởng chính của Loop Engineering. Lưu ý đây là những thử nghiệm sau khi đọc các ý tưởng trên và hiện thực chúng bằng một plugin cho Claude Code. Mình chưa so nó với việc dùng thẳng CLAUDE.md, hooks và /goal, và mới áp dụng thử để cải thiện UI/UX cho chính blog này, nên mình vẫn đang tiếp tục đánh giá qua công việc thật :)
Ba ý tưởng chính#
Mình sắp xếp theo thứ tự thời gian của từng ý tưởng. Theo cách mình thấy, qua từng giai đoạn người ta nhìn vòng lặp ở tầm rộng dần: từ “cho agent lặp lại”, tới “bàn giao giữa các session”, rồi tới “thiết kế cả vòng lặp”.
1. Ralph loop (7/2025): lặp lại cho tới khi xong#
Ralph của Geoffrey Huntley, ở dạng đơn giản nhất, là một vòng while đưa cùng một prompt cho agent nhiều lần, mỗi vòng một context mới: chọn một việc từ file kế hoạch, làm, chạy test, commit.
Hai ý tưởng quan trọng nhất:
- Một việc mỗi vòng: chỉ chọn một việc cần làm và hoàn thiện nó.
- Backpressure: test, type checker và mọi thứ từ chối đầu ra xấu mới là phần việc kỹ thuật thật.
Trong bài gốc, Huntley viết Ralph chỉ bằng đúng một dòng Bash (“in its purest form, Ralph is a Bash loop”):
while :; do cat PROMPT.md | claude-code ; done
Đọc từng phần:
while :; do ... done: lặp mãi, không có điều kiện dừng.cat PROMPT.md | claude-code: mỗi vòng chạy một agent mới với cùng một file prompt, nên không mang context của vòng trước.- Agent biết mình đang ở đâu nhờ file trên đĩa: prompt của Huntley bảo nó đọc thư mục specs và
fix_plan.md, chọn việc quan trọng nhất, làm xong thì cập nhật kế hoạch.
Một vòng lặp trông như sau (sơ đồ của mình, theo mô tả trong bài):
flowchart LR
    P["PROMPT.md<br/>(không đổi)"] --> A["Agent mới, context trống"]
    A --> R["Đọc specs + fix_plan.md"]
    R --> W["Chọn MỘT việc và làm"]
    W --> T["Test, type check<br/>(backpressure)"]
    T --> C["Commit, cập nhật fix_plan.md"]
    C -->|"vòng kế tiếp"| P
Mình học từ Ralph hai điều: mỗi session là một context mới, và backpressure trở thành luật do script chạy (câu hỏi 2). Phần Coder và Tester thì không phải lấy từ Ralph. Huntley còn không thích kiểu nhiều agent phối hợp, tuy nhiên mình muốn thử nghiệm thêm cái đó: mình tách người chấm ra khỏi phần viết code (câu hỏi 3), và đưa lỗi tester báo cáo thẳng vào context của lần thử sau, thay vì để người vận hành tự chỉnh prompt. Lưu ý Huntley khuyên Ralph cho dự án mới, còn blog này là codebase có sẵn.
2. Harness của Anthropic (11/2025 và 3/2026): cách bàn giao giữa các session bằng file và Evaluator#
Ralph Loop để agent lặp lại cho tới khi xong việc. Anthropic nhìn cùng bài toán từ một góc nhìn khác: cái thiếu không phải thêm vòng lặp, mà là cách bàn giao giữa các session. Họ có hai bài và đưa ra những ý tưởng đáng chú ý.
Bài viết Effective harnesses for long-running agents (11/2025): Cách để session mới biết mình đang ở đâu
Bài viết mô tả session như một ca trực không có bàn giao. Họ dùng hai vai, chỉ khác nhau ở prompt đầu tiên: một initializer chạy một lần, và một coding agent chạy ở mọi session sau.
- Initializer dựng hiện trường bàn giao:
feature_list.json(hơn 200 feature cho bản clone claude.ai của họ, ban đầu đềupasses: false, mỗi feature cósteps), một file progress,init.shđể khởi động môi trường, và commit đầu tiên. - Mỗi session sau đọc progress và git log, chọn một feature chưa xong, chạy
init.shcùng một bài test cơ bản, làm đúng một feature, test như người dùng thật bằng browser automation, rồi commit và ghi progress. Mục tiêu là để lại một trạng thái “sạch” có thể merge. - Agent chỉ được đổi trường
passes, không được xoá hay sửa feature. Họ chọn JSON vì model ít tự ý sửa JSON hơn Markdown.
Hình dung bàn giao qua file (sơ đồ của mình, không phải hình trong bài gốc):
flowchart TD
    I["initializer (chạy 1 lần)"] --> F["feature_list.json (passes: false hết)<br/>progress file, init.sh, commit đầu"]
    F --> A["Session mới: đọc progress + git log"]
    A --> B["init.sh + test cơ bản"]
    B --> C["Làm đúng 1 feature"]
    C --> D["Test như người dùng thật (browser)"]
    D --> E["Commit + ghi progress<br/>để lại trạng thái sạch"]
    E -->|"session kế tiếp, context mới"| A
Luật “chỉ đổi passes” có thể diễn đạt như sau:
allowed:    feature.passes: false -> true
forbidden:  delete a feature, edit its steps, edit its description
Điểm cần nhớ: ở bài này, chính coding agent tự kiểm tra feature của nó (“self-verify”) trước khi đánh dấu pass. Họ để ngỏ câu hỏi liệu một agent chuyên biệt (tester, QA) có tốt hơn không.
Bài viết Harness design for long-running application development (3/2026): tách Evaluator ra riêng, khi việc đủ khó
Bài viết đi tiếp theo hướng từ phần trước, và đưa ra một câu trả lời một phần: agent “reliably skew positive when grading their own work” (luôn có xu hướng chấm công việc của chính mình quá tích cực), còn tách người làm khỏi người chấm là “a strong lever”. Họ dùng ba agent: planner, generator và evaluator (chạy app thật bằng Playwright để chấm). Có những ý như sau:
- Sprint contract: trước mỗi sprint, generator và evaluator thoả thuận “thế nào là xong” rồi mới làm.
- Evaluator phải được hiệu chỉnh: tác giả nói Claude làm QA mặc định khá dễ dãi, tìm ra lỗi thật rồi tự thuyết phục mình là ổn, nên phải đọc log và chỉnh qua nhiều vòng.
- Gỡ bớt khi model mạnh lên: với Opus 4.6 họ bỏ cấu trúc sprint và chỉ cho evaluator chạy một lần ở cuối, vì với việc model tự làm tốt thì evaluator chỉ là chi phí thừa. Bài học của họ là phải xem lại harness mỗi khi có model mới.
Sơ đồ ba agent (mình vẽ lại cho dễ nhớ):
flowchart LR
    P["planner"] --> S["spec"]
    S --> G["generator"]
    G -->|"xong sprint"| E["evaluator<br/>(chạy app thật bằng Playwright)"]
    E -->|"lỗi: làm lại"| G
    E -->|"đạt"| N["sprint tiếp theo"]
Mình học từ hai bài:
- Backlog dạng JSON,
init.shvà file progress (câu hỏi 1). - Tách Evaluator khỏi agent viết code (câu hỏi 3).
Có hai điều mình tự thêm, không phải của Anthropic. Một là mình đặt Tester chạy model mạnh hơn Coder (mặc định Opus cho Tester, Sonnet cho Coder), vì mình đoán việc bắt lỗi thường khó hơn việc viết; đây mới là giả thuyết, mình chưa đo, và khi Coder được nâng lên Opus sau vài lần fail thì hai bên cùng model. Hai là mình chưa làm sprint contract, hẹn sẽ thử trong vài bản cập nhật sau :))
3. Loop engineering (từ 6/2026): thiết kế cả vòng lặp, không chỉ viết prompt#
Ralph cho agent lặp lại, Harness của Anthropic nêu ý tưởng về việc bàn giao giữa các session. Loop engineering hỏi rộng hơn: cả vòng lặp bắt đầu khi nào, ai chấm, và dừng ra sao.
Theo IBM và MindStudio, việc của kỹ sư dịch chuyển từ viết prompt sang thiết kế vòng lặp thúc đẩy, kiểm tra và dẫn dắt (prompt, check and guide) agent.
Tổng hợp các nguồn (preprint 2607.00038, khảo sát 2608.21884), một vòng lặp tốt cần 6 thứ (tên gốc trong ngoặc):
- Trigger (schedule or repository events): khi nào chạy, bằng tay, theo lịch hoặc theo sự kiện.
- Trạng thái bền (persistent state files; memory; “spine”): file lưu tiến độ, không nằm trong trí nhớ của agent.
- Verifier tách riêng (verifier subagents; verification): người chấm không phải người viết.
- Luật dừng (stopping rule; machine-checkable stop conditions; terminal states): khi tác vụ đã xong việc, khi nó bị kẹt (stuck), hết ngân sách (out of budget), cần con người quyết định, …
- Ngân sách (budget; token budgets): token, tiền, thời gian.
- Leo thang cho người (human escalation points): điểm bàn giao rõ ràng khi agent không tự quyết được.
Gộp sáu thứ này lại thành pseudo-code (do mình tổng hợp để minh hoạ, không phải mã của nguồn nào):
on trigger:                           # schedule, event, or manual
    while true:
        state = read_state_file()     # not the agent's memory
        if state.done:           stop
        if state.out_of_budget:  stop
        if state.stuck:          ask_human(); stop   # escalation
        result = agent.work(state.next_item)
        verdict = verifier.check(result)             # not the agent that wrote it
        write_state(state, verdict)
Lưu ý: Loop Engineering vẫn còn khá mới (khoảng tháng 6/2026) và nguồn cũng ít đánh giá đầy đủ, chính bài khảo sát cũng ghi chưa có bằng chứng hệ thống về lợi ích của nó.
Thứ mình đã học là dùng sáu thứ ở trên để dựng vòng ngoài của plugin (câu hỏi 2 và 3).
Ngoài ra mình thêm các bậc L1 đến L3. Mình không thấy chúng trong các nguồn đã đọc, đây là thiết kế của riêng mình, với lý do là muốn vòng lặp kiếm dần niềm tin thay vì cho chạy không người trông ngay từ đầu:
| Bậc | Chạy ở đâu | Kết quả |
|---|---|---|
| L1 (shadow) | nhánh riêng, xong quay về nhánh cũ | báo cáo (số commit, diffstat); nhánh của mình không bị đụng |
| L2 (assisted) | nhánh riêng | có thể push và mở PR để mình review |
| L3 (unattended) | nhánh hiện tại | commit thẳng |
Trigger mới tạo mặc định ở L1. Workflow GitHub Actions do plugin sinh ra từ chối L3, nên CI không bao giờ commit lên nhánh mặc định.
Cách ba ý khớp nhau về Long-running agent và thiết kế vòng lặp#
Cách mình hình dung (không phải định nghĩa chính thức), ba ý này lồng vào nhau như ba lớp:
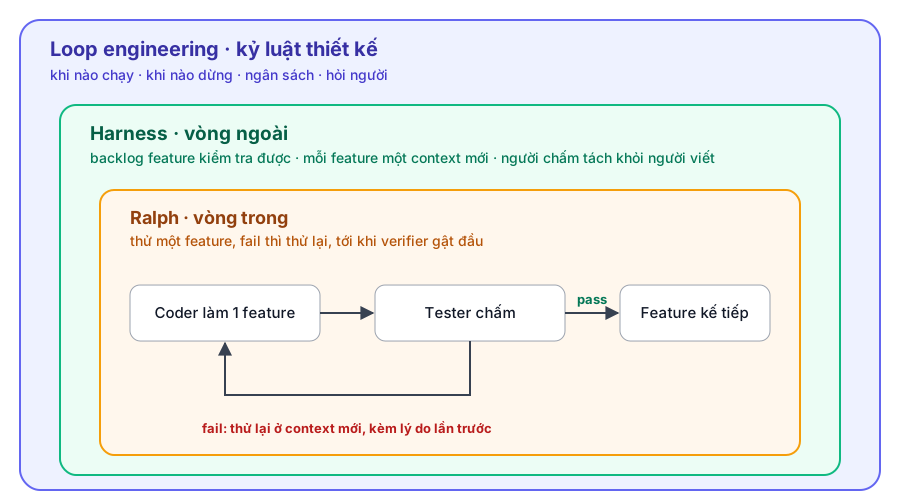 Ba lớp lồng nhau (sơ đồ của mình, không phải hình trong các nguồn).
- Ralph là vòng trong. Trong plugin, nó là việc thử lại một feature ở context mới, mỗi lần kèm lý do lần trước fail. “Verifier gật đầu” là phần mình thêm: Ralph gốc chỉ có test làm backpressure, chưa có người chấm riêng.
- Harness là vòng ngoài. Nó lo việc nhớ và bàn giao: danh sách feature nằm trong file, mỗi session lấy một việc, và người chấm tách khỏi người viết (câu hỏi 1 và 3).
- Loop engineering là kỷ luật thiết kế bao trùm cả hai. Nó biến luật dừng, kiểm tra và ngân sách thành thứ khai báo rõ trong config và do script thực thi, thay vì nằm trong prompt (câu hỏi 2 và 3).
Plugin có gì#
Từ ba lớp ở trên, mình thiết kế wreck-it-ralph chạy mỗi session theo một đường thẳng:
chọn feature sẵn sàng → coder (context mới) → chạy lệnh verify → tester (context mới) → kiểm tra cuối session
coder làm một feature rồi claim (“mình nghĩ xong rồi”); tester là agent riêng, chạy lại rồi mới được pass hoặc fail (“mình thấy ổn rồi, hay LGTM :)”); proposal là đề xuất thêm hoặc sửa việc trong backlog, người duyệt mới có hiệu lực để làm tiếp.
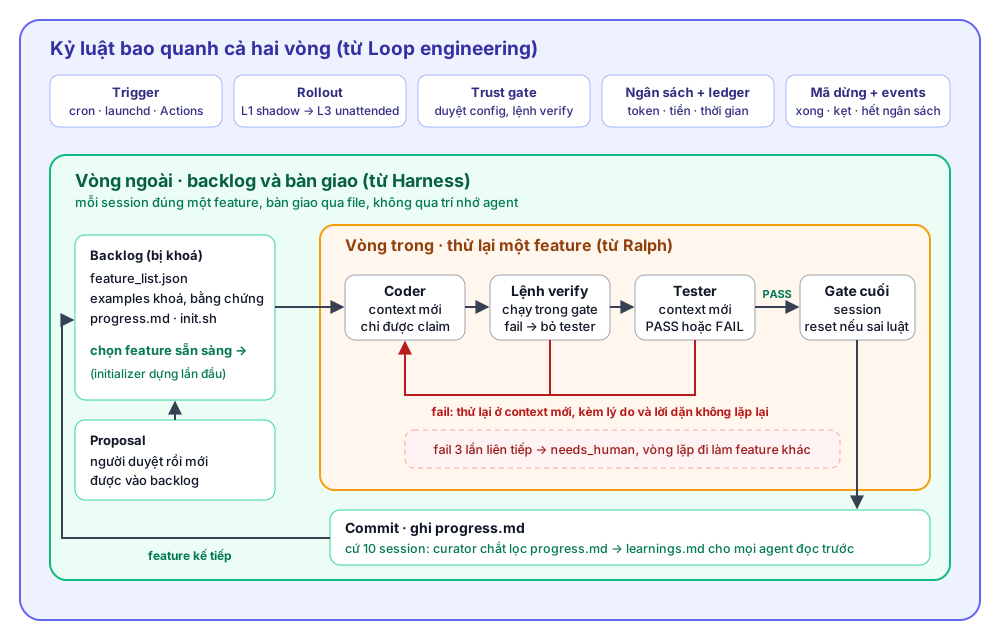 Toàn cảnh plugin (sơ đồ của mình). Phần nào thuộc vòng nào được mô tả chi tiết ngay dưới.
Vòng trong: thử lại một feature (từ Ralph)#
- Thử lại ở context mới, kèm lý do lần trước fail và lời dặn không lặp lại cách đã fail.
- Lệnh
verifycủa feature chạy trong gate, không chạy trong agent. Fail thì bỏ qua tester luôn, đỡ tốn tiền (backpressure thành luật do script chạy). - Fail liên tiếp 3 lần thì feature chuyển thành
needs_human, và vòng lặp đi làm việc khác thay vì kẹt mãi. - Ngoài ra còn chế độ Ralph trong một session (
/wreck-it-ralph:ralph) với--verifyvà--max-iterations, cho việc nhỏ.
Vòng ngoài: backlog và bàn giao (từ Harness)#
- Initializer viết
feature_list.json,progress.md,init.shvà commit đầu tiên. Mỗi session làm đúng một feature. - Feature list bị khoá: agent không sửa được, muốn thêm hay sửa việc phải qua proposal và người duyệt.
- Coder chỉ được
claim, tester riêng mới đượcpass. Cuối session, feature nào thànhpassingmà chưa được claim sẽ bị gate reset. - Example bị khoá và bằng chứng (mới, chưa có trong lần chạy trên blog): mỗi feature có các example (input, kết quả mong đợi). Coder phải cho test hoặc example fail đúng lý do trước khi viết code (RED rồi mới GREEN), và tester phải replay từng example trên app đang chạy. Không có bằng chứng thì không có PASS.
- Siết người chấm (mới thêm, mới kiểm bằng test script với
claudegiả, chưa chạy vớiclaudethật): gate hoàn tác nếu tester sửa code sản phẩm, nhưng chỉ sau khi xảy ra, chưa chặn được lúc tester ghi; tester gửi findings có cấu trúc lại cho coder; và có công cụ đo tỉ lệ false positive (chấm PASS khi thực tế hỏng). - Model theo vai: tester mặc định
opus, codersonnetvà được nâng lênopussau vài lần fail. Một agent curator cứ 10 session chắt lọcprogress.mdthànhlearnings.mdngắn để mọi agent đọc trước.
Kỷ luật thiết kế: dừng, ngân sách, hỏi người (từ Loop engineering)#
- Mã dừng có tên: xong, kẹt, hết ngân sách, chờ người trả lời, và vài lý do khác.
- Ngân sách và sổ chi phí theo token, tiền, thời gian, kích thước diff.
- Trust gate: loop không chạy tới khi bạn duyệt config và các lệnh verify do repo cung cấp.
- Worktree song song cho các feature độc lập, trigger (cron, launchd, GitHub Actions) và rollout L1 đến L3 như mô tả ở trên.
- Event stream và
status.sh --jsonđể công cụ khác theo dõi.
Áp dụng: trùng tu giao diện đọc bài của blog này#
Mình muốn nâng cấp trải nghiệm đọc bài của blog (theme Minimal Mistakes): typography, TOC, dark mode, code block, ảnh… Bài của Anthropic cũng thử long-running agent trên một web app, nên mình chọn một việc web để thử. Mình giao việc đó cho harness, với mục tiêu ghi trong feature_list.json là “hllj.github.io post-page UI/UX”.
Lần chạy này dùng gì#
Đây là lần chạy với bản thô sơ của plugin, ngày 18/11, tức mới có những ý mình lấy từ ba bài ở trên: initializer, feature_list.json bị khoá, coder claim rồi tester pass ở context mới, lệnh verify chạy trong gate, tester điều khiển trình duyệt thật (preset web), curator chắt lọc learnings.md. Lúc đó chưa có example, replay, bằng chứng, model theo vai hay gate hoàn tác tester. Mình chạy ở chế độ interactive (subagent ngay trong session), nên sổ chi phí chỉ có token, không có chi phí bằng tiền.
Các bước mình đã trải qua#
- Lập backlog. Initializer tách mục tiêu thành 42 feature nhỏ, mỗi feature có
stepsvà lệnhverify, ví dụ: thanh tiến độ đọc (reading progress bar), Table of Contents (TOC) tô sáng mục đang xem, nút copy cho code block, lightbox ảnh, dark mode, print stylesheet… - Chạy vòng lặp. Mỗi session một feature. Coder sửa SCSS và JS rồi
claim; tester mở trang thật ở 375, 768, 1280 px, light và dark, đo DOM, rồipasshoặcfail. Tester bắt được những lỗi có số đo cụ thể, ví dụ chữ liên kết có tỉ lệ tương phản 3.94:1 (cần 4.5:1) ở feature F035, chữ “On this page” trong dark mode chỉ đạt 3.92:1 ở F021, và tagline đè lên mục Home ở màn hình 375 px ở F042. - Nhìn lại và thêm việc. Xong 42 feature, mình xem lại trang và còn nhiều chỗ chưa ổn: breadcrumb lệch hàng, nút “back to top” tràn chữ, thẻ bài ở trang chủ chồng lên đường kẻ, TOC có một cái hộp thừa… Planner biến chúng thành các proposal (P001–P012, trong đó P005 và P006 chỉ sửa lệnh verify) để mình duyệt, cho ra 23 feature mới (F043–F065) từ các nhận xét của mình. Riêng TOC phải làm lại nhiều lần (F059, F060, F064…): các feature đó ghi
REWORKkèm lời nhận xét của mình, ví dụ “I see a wrapper box in this button”.
Có một lỗi không nằm ở code: feature F054 hai lần verify_failed vì lệnh verify do planner viết sai. Lệnh đầu trỏ tới trang không tồn tại hoặc không có sidebar (P005 sửa), lệnh sau viết nhiều dòng mà gate tách mỗi dòng thành một lệnh riêng (P006 sửa). Nghĩa là verifier cũng có lỗi như bất kỳ đoạn code nào.
Kết quả chạy#
| Feature | 65/65 pass (42 ban đầu + 23 thêm sau) |
| Session | 83, chia thành khoảng 10 lượt chạy |
| Thời gian chạy | khoảng 2 giờ 40 phút, rải trong 7 giờ 24 phút (13:37 – 21:01, ngày 18/11) |
| Lượt chạy agent | 192 (tester 97, coder 92, curator 3) |
| Token | khoảng 12,6 triệu (theo Agent tool; chưa đo đô la) |
| Sự kiện pass / fail | 71 / 11 |
| Feature có ít nhất một lần fail | 10 |
verify_failed |
2 (cả hai ở F054, do lệnh verify, không phải do code) |
Về sau mình còn dùng lại harness này cho 6 feature nữa (F066–F071, ngày 21/11: menu Follow có form đăng ký email và liên kết RSS). Bài này chỉ nói về lần chạy 18/11.
Kết quả trước và sau#
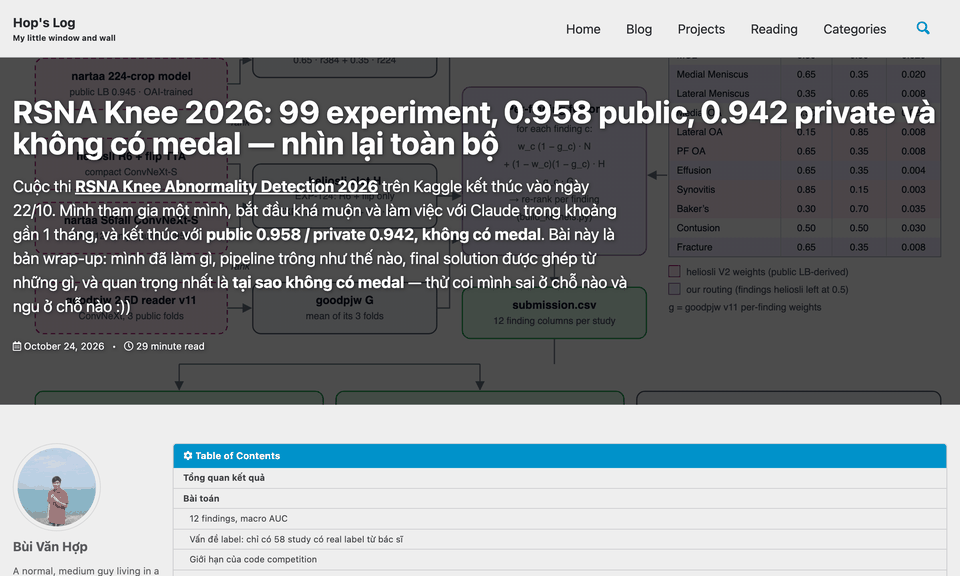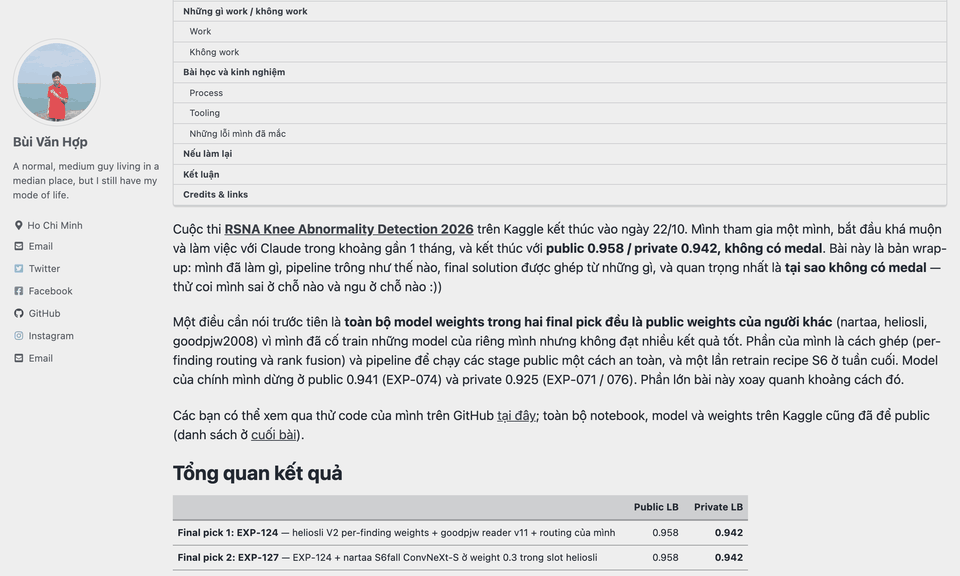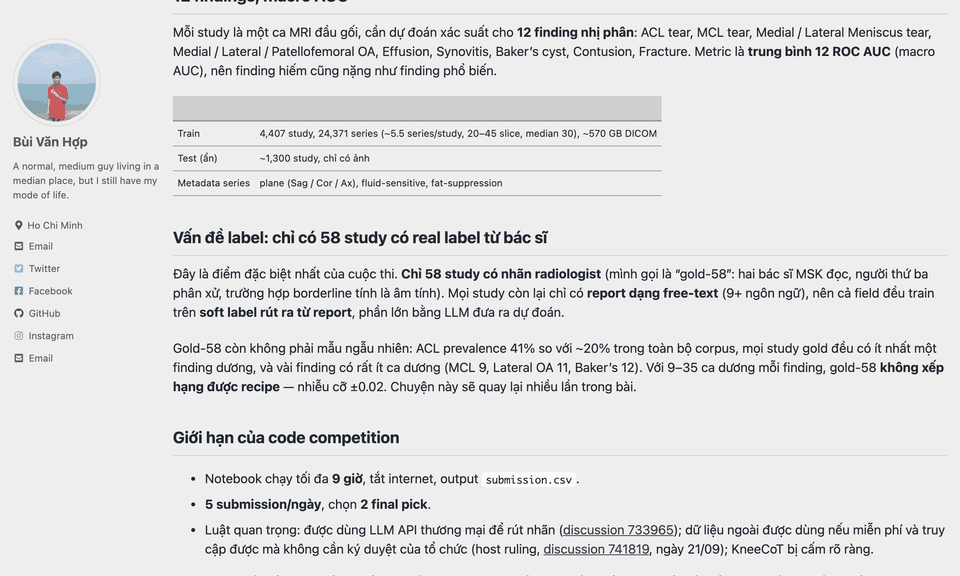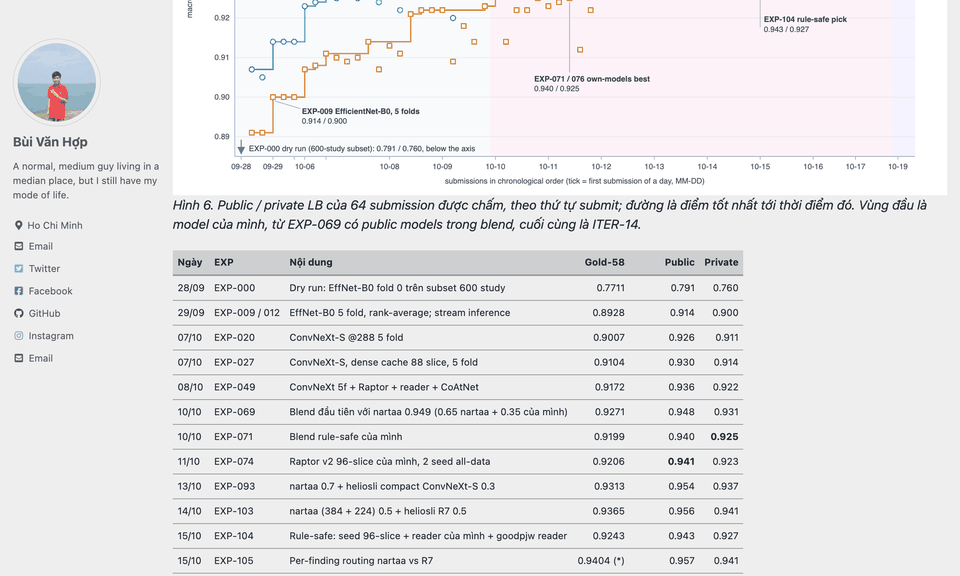
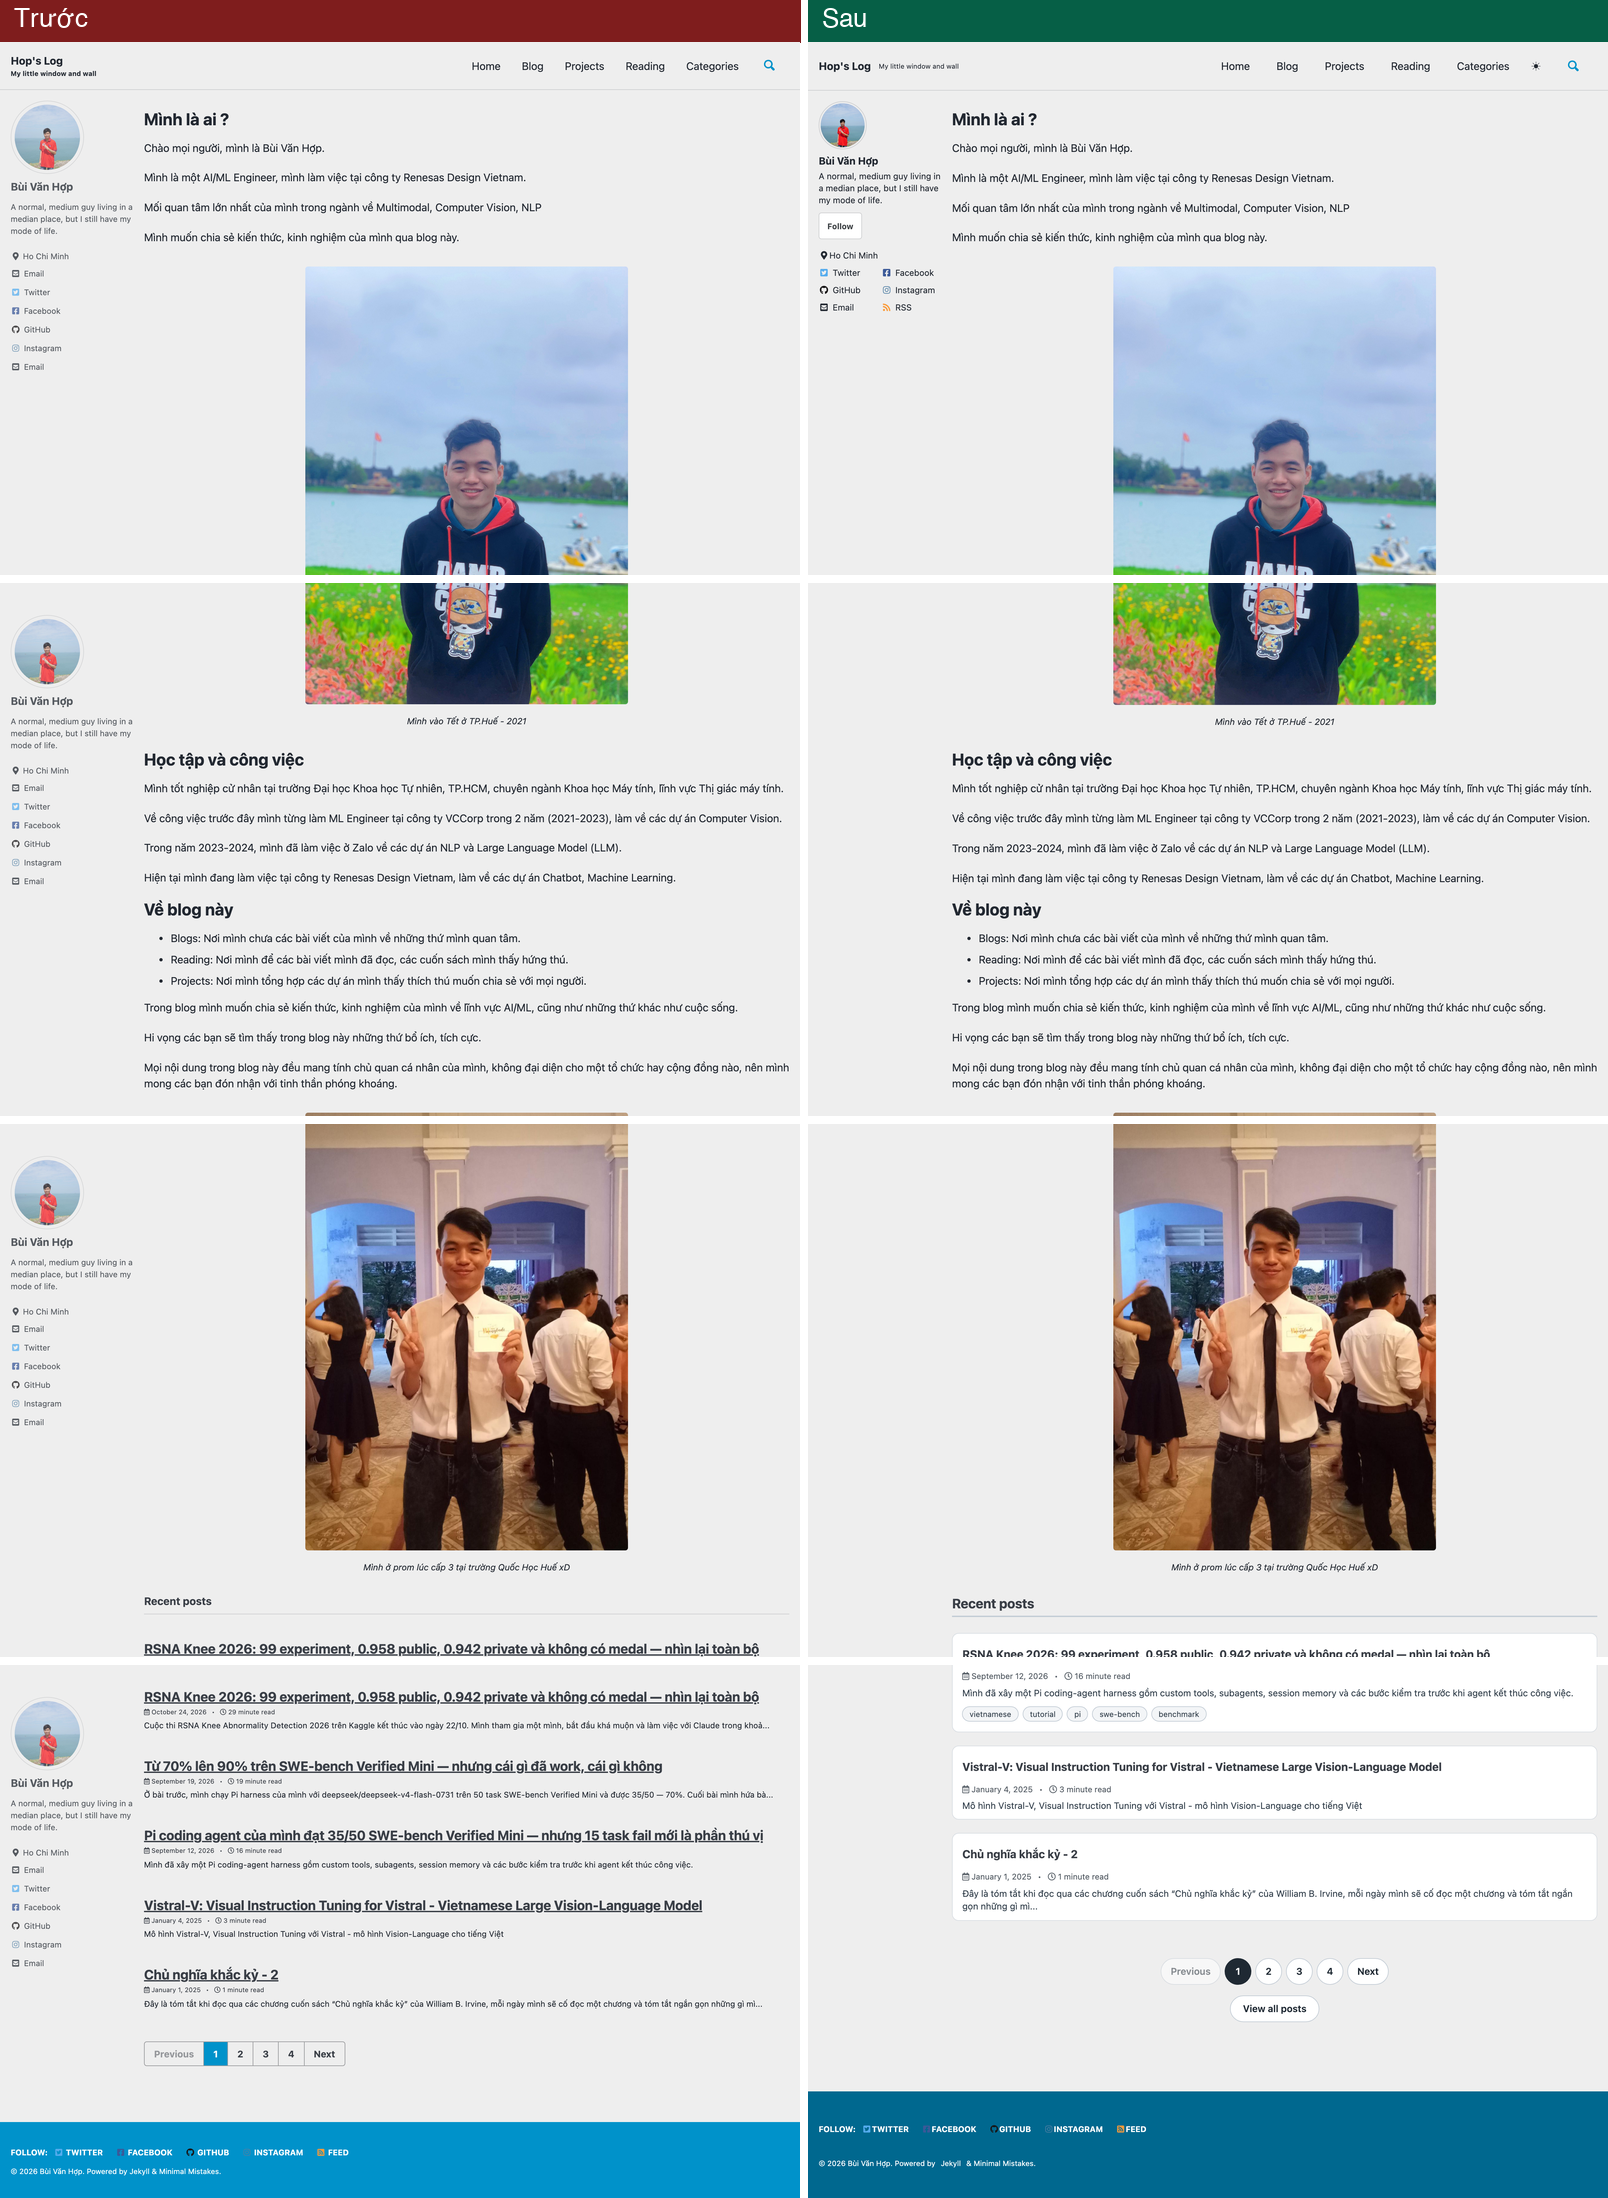
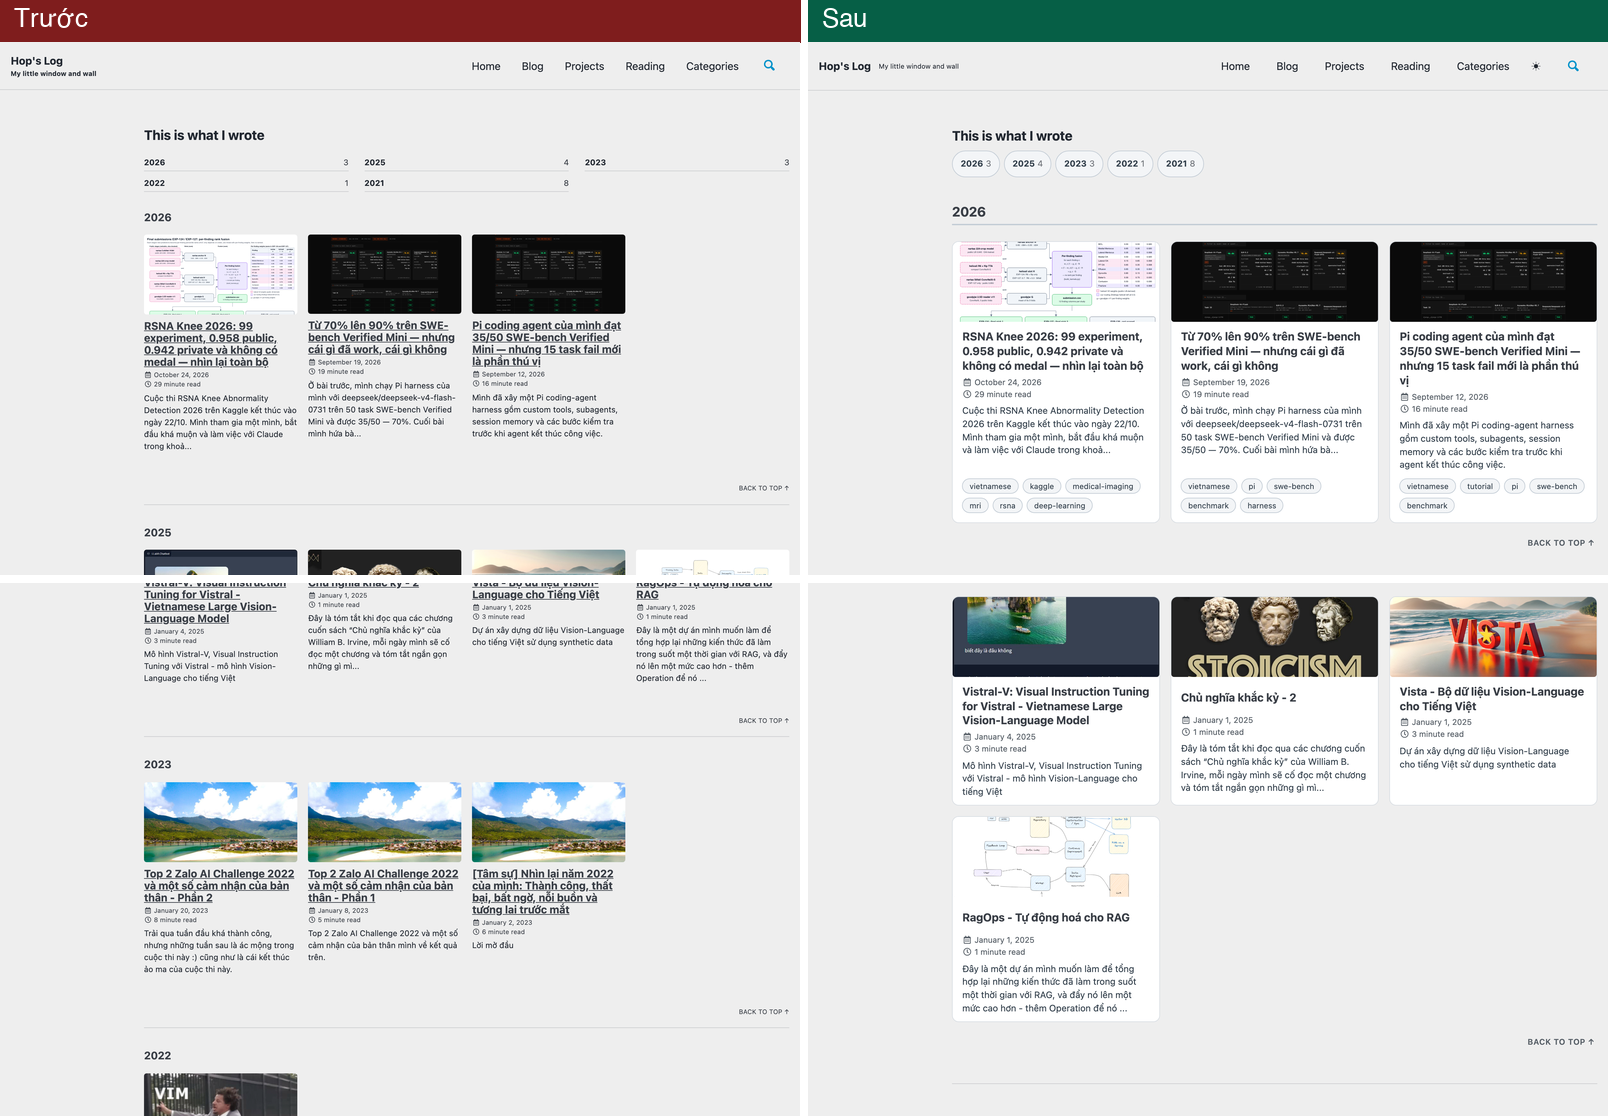
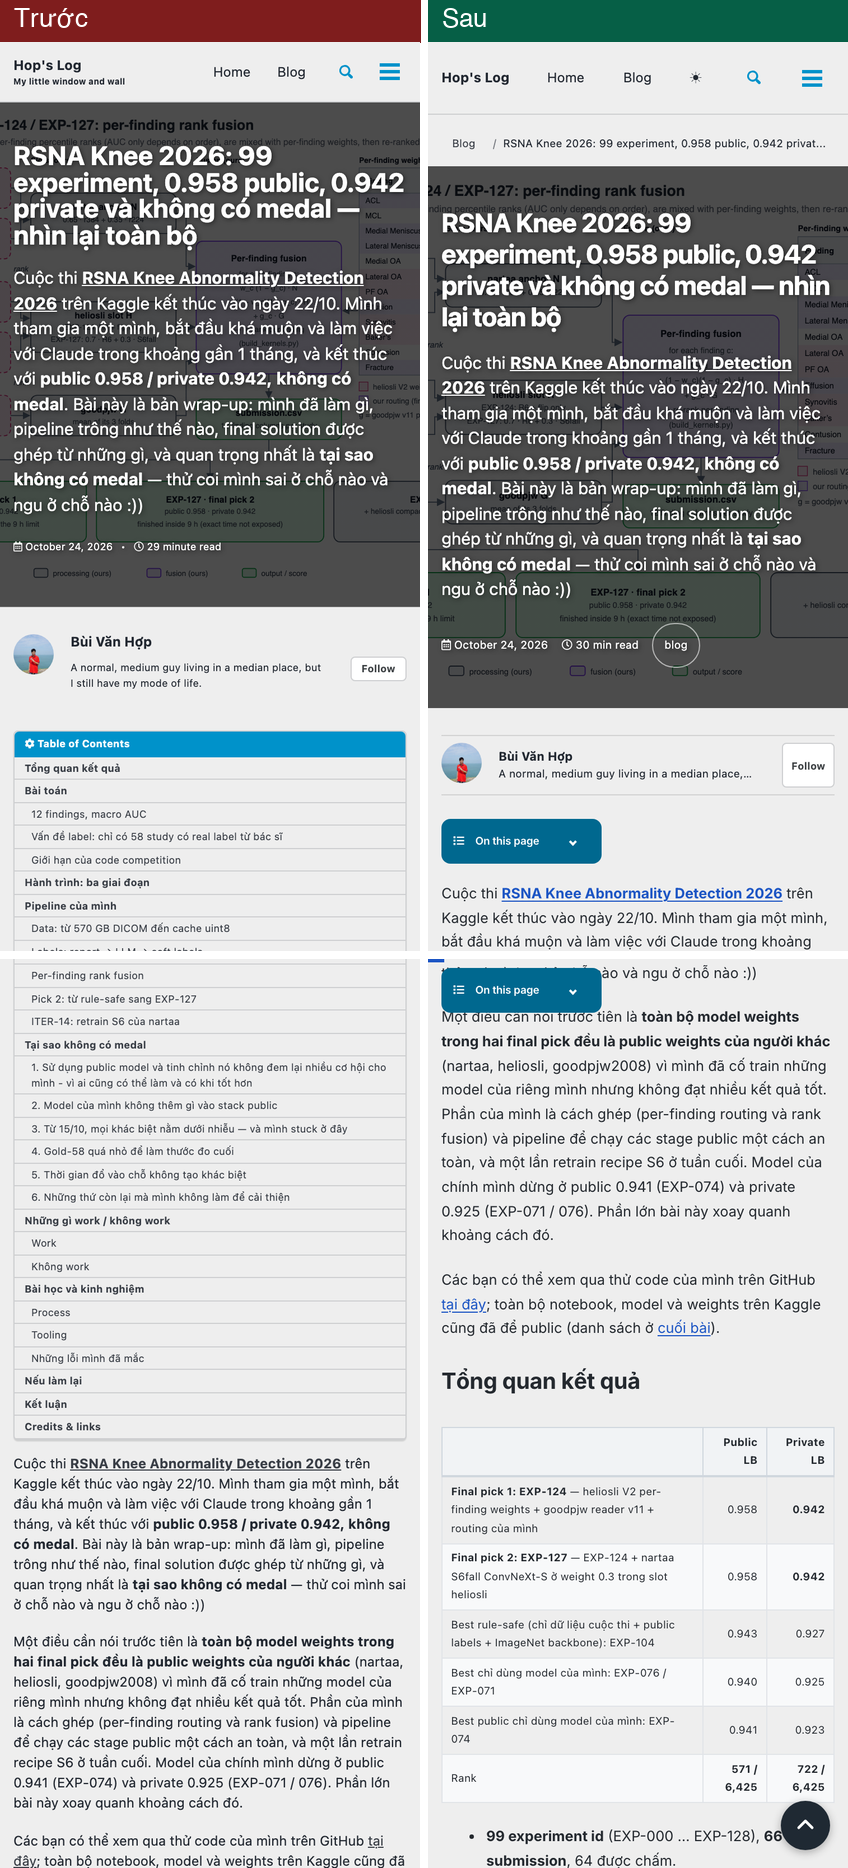
“Trước” là commit ngay trước khi harness khởi tạo (de66921f~1, bản của 24/10), “sau” là bản hiện tại (gồm cả các feature F066–F071 của lần chạy tiếp theo ngày 21/11). Mình chụp bằng trình duyệt headless, cùng một trang, cùng kích thước màn hình.
Trang bài viết#
Cùng một bài (RSNA Knee 2026), cuộn từ đầu xuống, màn hình 1200px.
Trước:
Sau:
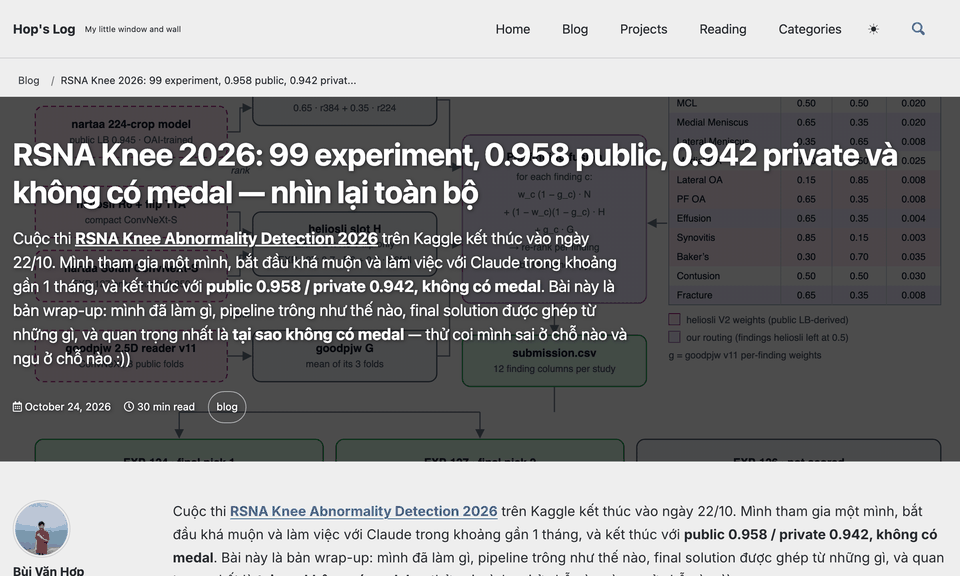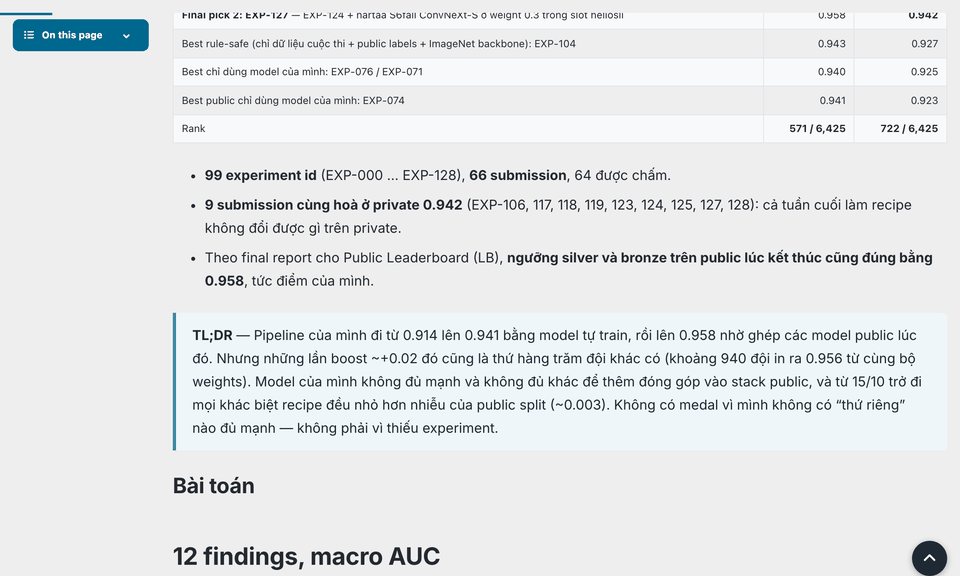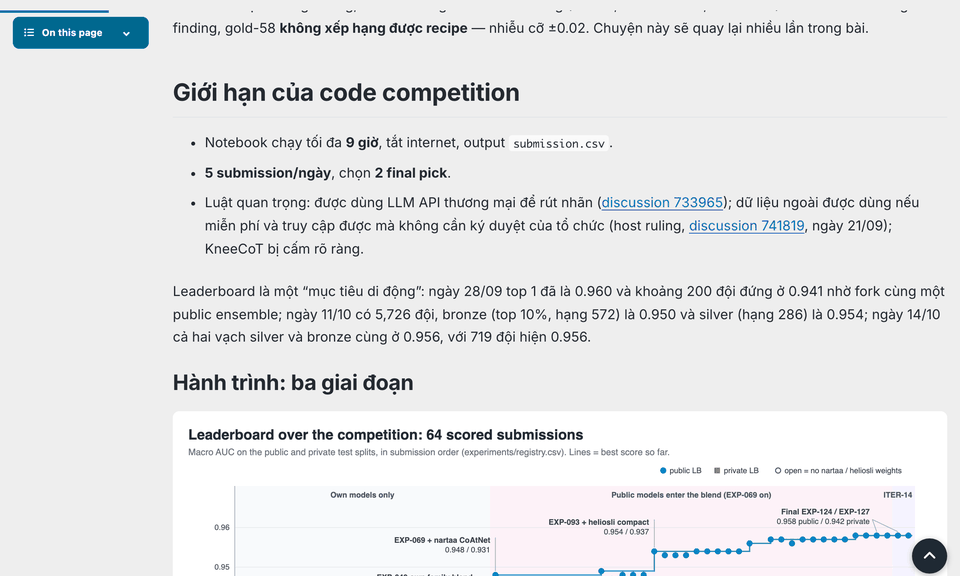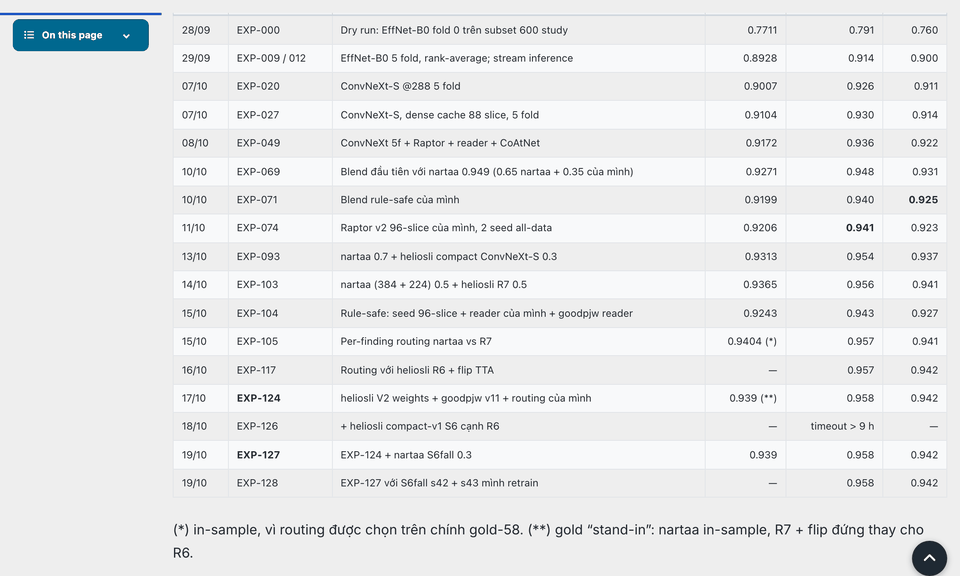
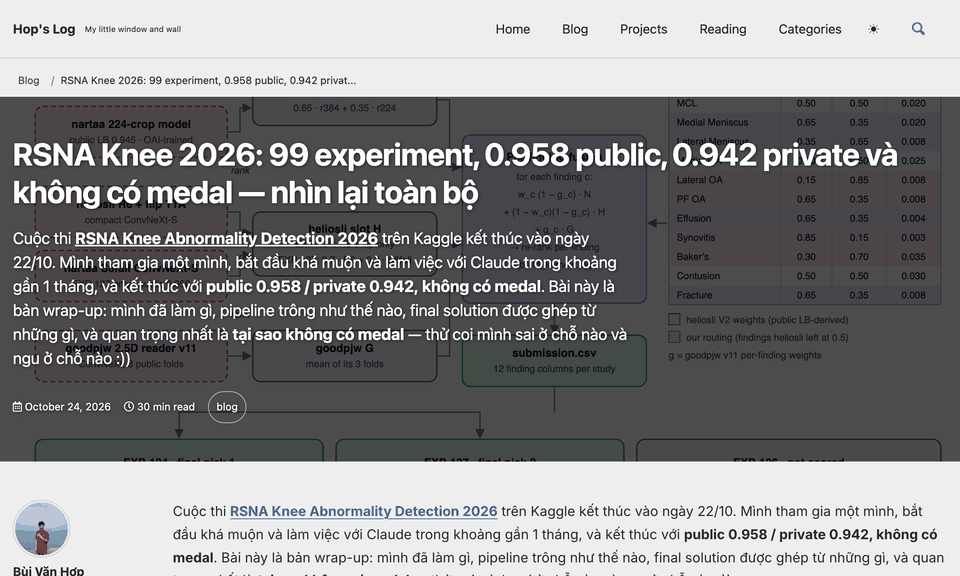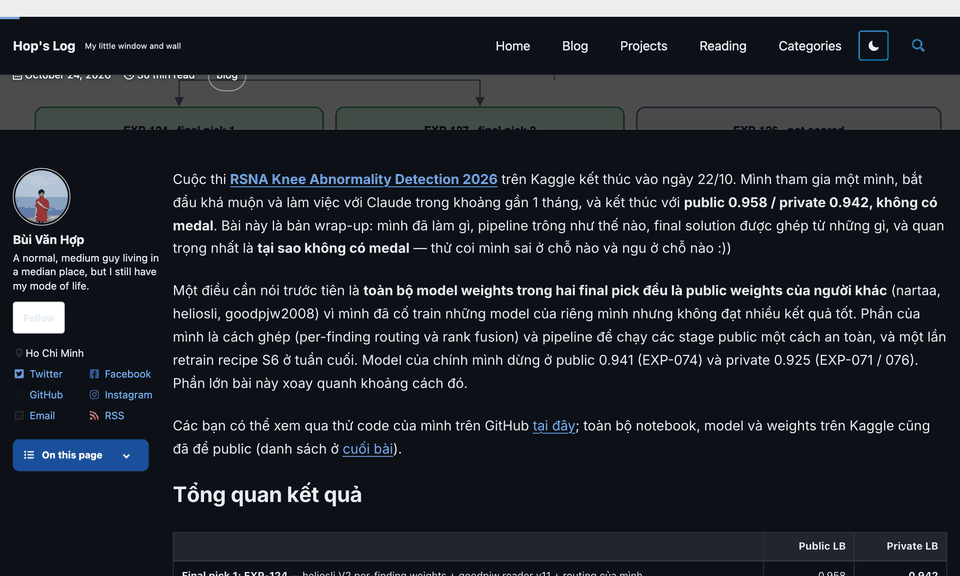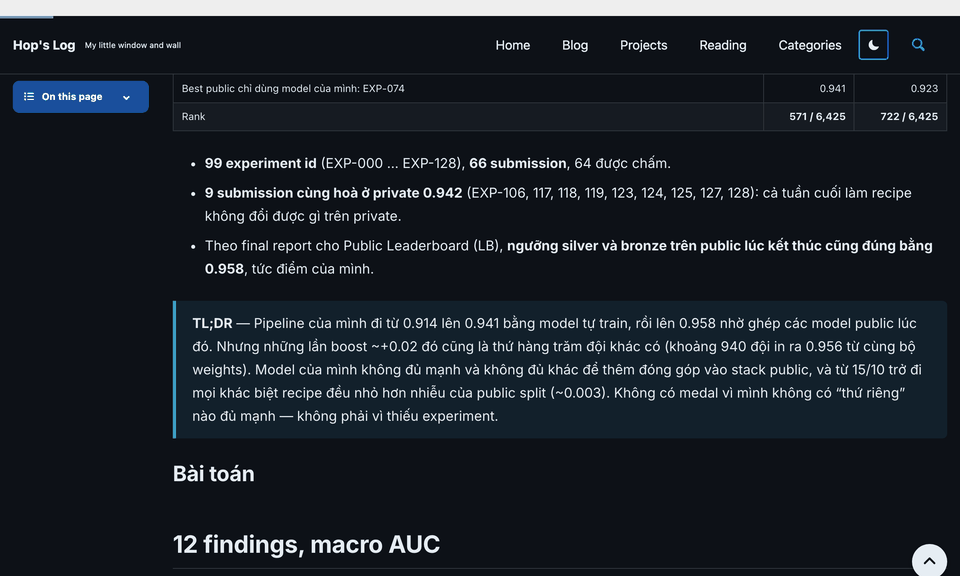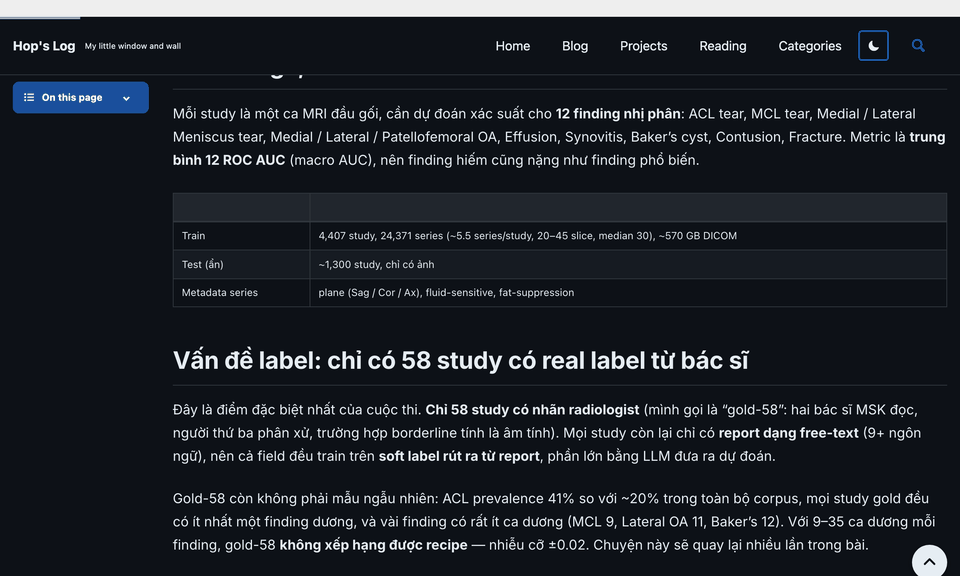
Khác biệt dễ thấy: font và độ rộng dòng chữ thân bài, breadcrumb và hàng thông tin bài (ngày, thời gian đọc, category), mục lục dính phía trên thay vì khung “Table of Contents” nằm trong bài, và nút quay lên đầu trang.
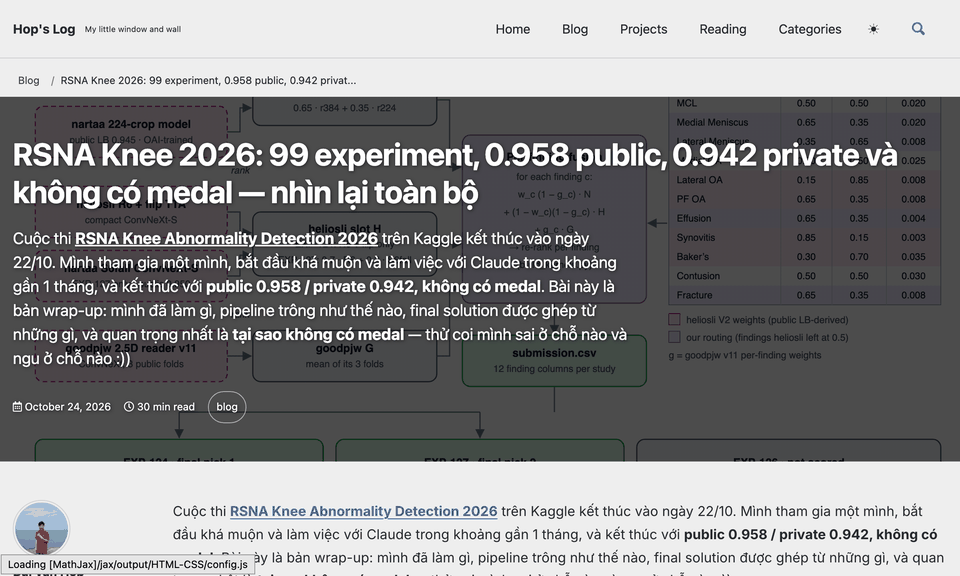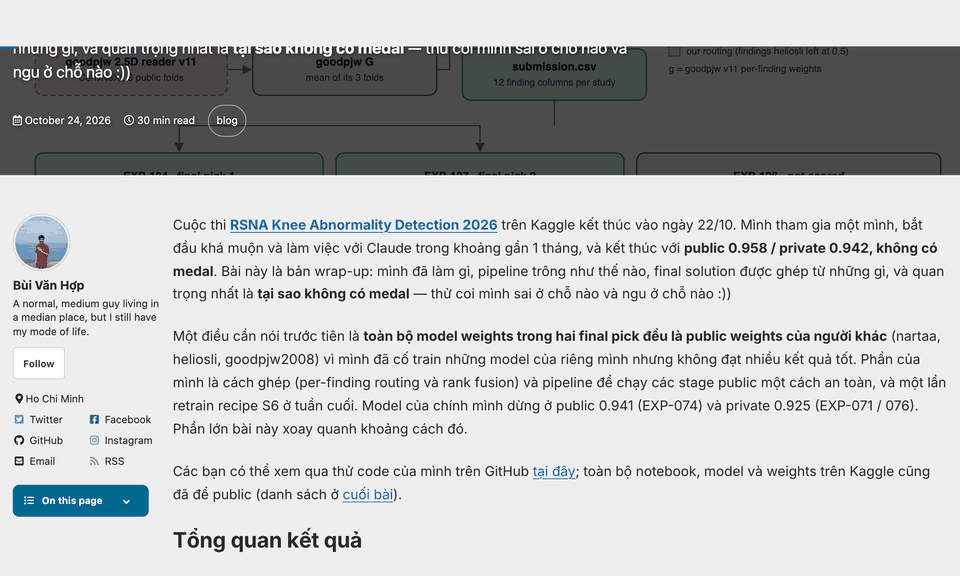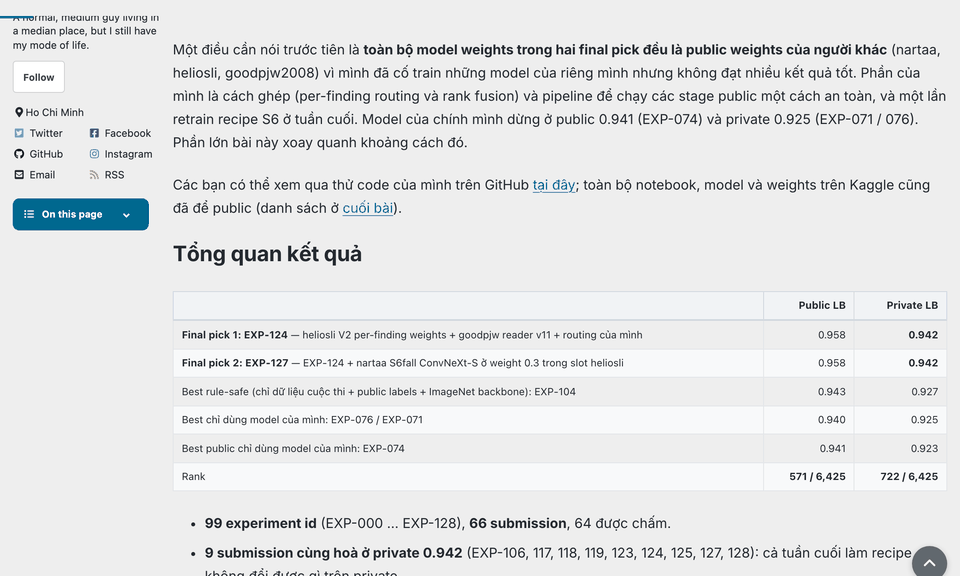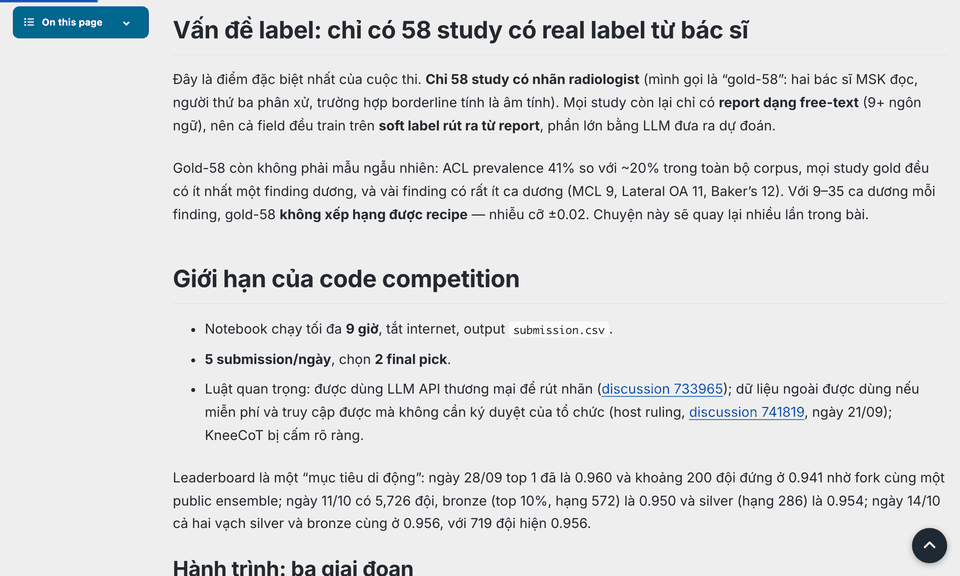
Mục lục “On this page”#
Phần mình sửa nhiều lần nhất (F059–F065). Nút nằm ở sidebar trái, cuộn theo trang, bấm mở danh sách ngay bên dưới nút, bấm một mục thì nhảy tới phần đó.
Chế độ tối#
Bản cũ không có nút đổi giao diện. Bản mới có nút ở thanh trên cùng, theo prefers-color-scheme và nhớ lựa chọn (F020, F021).
Trang chủ#
Mình chụp bốn vị trí khi cuộn xuống: đầu trang, phần giới thiệu, phần “Recent posts” và cuối trang. Sidebar tác giả gọn hơn, có nút Follow và link RSS, và không còn mục Email bị lặp (F052–F054). Danh sách “Recent posts” dùng chung card và tag dạng pill với trang /blog/ (F055–F057), phân trang và footer cũng được làm lại.
Trang /blog/#
Từ danh sách kèm bảng năm sang lưới card có tag, nút chọn năm dạng pill (F032, F048–F051).
Trên điện thoại#
Màn hình 375px, đầu bài và sau khi cuộn: khung mục lục dài chiếm gần hết màn hình được thay bằng một nút gọn dính phía trên (F009, F065).
Đánh giá#
Ưu điểm#
- Luật nằm trong script, không nằm trong prompt. Gate chạy lệnh
verify, khoá danh sách feature, và reset feature nào thànhpassingmà chưa qua tester. - Tester bắt được lỗi có số đo: 9 lần tester fail một feature kèm số liệu (ví dụ tương phản 3.94:1, tagline đè menu ở 375 px), thay vì tin lời coder.
- Backlog “sống”: sau khi xem lại trang, mình thêm được 23 feature qua các proposal mình duyệt mà không phải làm lại từ đầu, và vòng lặp chạy qua 83 session mà không kẹt.
- Có chỗ cho con người:
needs_human, ngân sách, rollout L1 đến L3 (lần chạy này chưa phải dùng tớineeds_human). - Định vị rõ: đây là harness cấp dự án (backlog nhiều feature, nhiều session), không phải một Ralph loop “mạnh hơn” và không thay thế
/goalcủa Claude.
Nhược điểm#
- Chưa có Benchmark, chưa có baseline so sánh với Claude Code gốc Kết quả chính là 65 feature trên một project, một lần chạy, cùng vài lần thử nhỏ khác (một API Python 3 feature, một CLI todo). Mình chưa so với Claude Code thường hay với lệnh
/goal. - Tester độc lập về context, chưa độc lập về phán đoán: cùng họ model với coder. Một số
REWORKlà những lần mắt người thấy lỗi mà tester đã cho qua (cái hộp thừa quanh nút TOC ở F059); số khác là mình đổi ý (F064, danh sách phải mở bên dưới nút). - Verifier cũng có lỗi, như lệnh
verifysai ở F054. - Plugin đang hơi phức tạp quá Nhiều tính năng (trigger, intake, rollout, worktree song song) chưa được dùng thật nhiều, và có tới 17 lệnh cho người mới. Xin lỗi mình cũng vibe code để ra cái plugin này thôi :)))
- Tính năng mới chưa chạy thật: phần siết người chấm mới được kiểm bằng test script với
claudegiả. - Mặc định an toàn chưa chặt: config thiếu
permission_modesẽ rơi vềbypassPermissions, và commit tự động còn dùnggit add -Amà chưa quét secret.
Những phần tiếp theo#
- Chạy các tính năng mới với
claudethật (tester chỉ đọc, findings, hiệu chỉnh người chấm) và ghi lại cái gì vỡ. - Siết mặc định an toàn: rơi về
acceptEditsthay vìbypassPermissions; thaygit add -Abằng danh sách cho phép kèm quét secret; không tự tin cậy lệnh verify do agent viết. - Benchmark: So sánh Claude Code thường,
/goal, plugin tuần tự, plugin song song; cùng đặc tả và model, lặp ít nhất 3 lần, đo tỉ lệ false-pass, regression, chi phí và thời gian cho mỗi feature đạt. Hoặc đơn giản là những real example như trong các bài viết của Claude mình giới thiệu. - Đo người chấm: cài bug có chủ đích để xem tester bắt được bao nhiêu, và thử tester dùng model khác họ.
- Thử sprint contract, kiểm tra theo mức rủi ro và quyền sở hữu file cho worktree song song, nhưng chỉ giữ lại thứ nào benchmark cho thấy đáng công.
- Đơn giản hoá cho plugin một lệnh
startcho người mới, đánh dấu trigger, intake, rollout là thử nghiệm, và gỡ bớt phần nào không còn cần khi model mạnh lên, theo bài học của Anthropic.
Kết bài#
Mình bắt đầu từ một câu hỏi: agent giỏi trong một session, vậy làm sao để nó làm trọn một dự án qua nhiều session mà mình vẫn tin kết quả? Claude Code đã giải quyết một phần. wreck-it-ralph là cách mình thử đóng gói thêm ba thứ: một backlog có cấu trúc, những luật nằm trong script thay vì trong prompt, và một người chấm tách khỏi người viết. Kết quả trên blog này là 65/65 feature pass, nhưng đó mới là một mẫu.
Mình rút ra ba điều:
- Luật quan trọng nên nằm trong code. Prompt chỉ là lời đề nghị, gate mới là luật. Nhưng một guard “hoàn tác sau khi xảy ra” vẫn yếu hơn “không được phép”.
- Verifier quan trọng hơn agent thông minh hơn, và verifier cũng có lỗi. Lệnh
verifysai ở F054 và một số lầnREWORK(tester cho qua một cái hộp thừa ở F059) cho thấy người chấm cũng cần được kiểm tra. - Chưa đo thì chưa được nói là tốt hơn. Harness cũng là software, và bước tiếp theo của mình là benchmark có đối chứng.
Plugin vẫn là một thử nghiệm: mình mới áp dụng thử để cải thiện UI/UX cho chính blog này và đang tiếp tục đánh giá nó qua công việc thật. Nếu bạn quan tâm phần nào cụ thể, cứ hỏi mình nhé.
Credits#
Ý tưởng:
- Ralph loop: Ralph Wiggum as a “software engineer”, Geoffrey Huntley (14/7/2025).
- Harness của Anthropic: Effective harnesses for long-running agents (11/2025) và Harness design for long-running application development (3/2026).
- Loop engineering: IBM, MindStudio, preprint arXiv 2607.00038 và khảo sát arXiv 2608.21884.
- Hook mẫu và evaluator: repo ví dụ anthropics/cwc-long-running-agents.
Mã nguồn:
- wreck-it-ralph (hllj/wreck-it-ralph, Apache-2.0) phát triển từ plugin Ralph Loop của Anthropic, PBC (cũng Apache-2.0). Vòng lặp Stop-hook trong một session (
/wreck-it-ralph:ralph) có nguồn gốc từ plugin đó; phần harness (agents, backlog, gate, các script) do mình thêm, theo ý tưởng từ các bài của Anthropic ở trên. - Sơ đồ và pseudo-code trong bài do mình vẽ để minh hoạ, không phải của các nguồn trên.
Leave a comment
Join the discussion. Comments are powered by Disqus and only load when you ask.